
Le 3 octobre 2026, Aleph Alpha a lancé Kolibri-1 : un grand modèle linguistique (LLM, Large Language Model) de type « open-weight ». Cela signifie qu’il s’agit d’un modèle dont les poids entraînés sont téléchargeables gratuitement et fonctionnent sur du matériel propre à l’utilisateur sous licence Apache 2.0. Développé par la société Aleph Alpha, basée à Heidelberg, il a été entraîné sur des serveurs situés en Allemagne et en Finlande. Pour les entreprises qui privilégient les fournisseurs et les solutions issus de l'espace juridique européen, Kolibri-1 peut donc constituer une option intéressante.
Le 12 octobre, Konfuzio a mené un petit test afin de vérifier si le modèle était capable de lire de manière fiable les factures, les relevés de compte et les attestations fiscales, et d'obtenir ainsi une première évaluation pratique du modèle allemand. Le test a été réalisé sur 17 documents financiers allemands et a suivi le même pipeline Konfuzio que le meilleur modèle ouvert à ce jour dans l'ensemble de données de test Konfuzio. Cet article décrit ce qu’est Kolibri-1 et en quoi un modèle européen dédié au traitement des documents se distingue des autres modèles ouverts. À la fin, nous présentons les résultats de nos tests et mettons en évidence les domaines dans lesquels Kolibri est compétitif, ainsi que ceux où le modèle présente encore des lacunes.
Qu'est-ce que Kolibri-1 ?
- Origine : Développé par Aleph Alpha Research GmbH, publié le 3 octobre 2026. Le groupe a son siège social à Heidelberg.
- Licence : Apache 2.0 pour les poids et les fichiers de configuration. Selon la carte du modèle, le code, l'architecture et les méthodes d'entraînement ne sont expressément pas couverts par la licence.
- Structure : « Mixture of Experts », c'est-à-dire un modèle composé de nombreux sous-réseaux, dont seuls quelques-uns effectuent des calculs pour chaque segment de texte (token). Au total, 78 milliards de paramètres, dont environ 3,46 milliards sont actifs par token. Le modèle est donc volumineux en mémoire, mais rapide à l'exécution.
- Langues : Allemand et anglais. Lors de la pré-formation portant sur 20 000 milliards de jetons, la part de l'allemand s'élevait à environ 23,9 %, celle de l'anglais à 62,5 % et celle du code à 13,6 %.
- Contexte : jusqu'à 1 048 576 jetons ; il est recommandé de ne pas dépasser 262 144 jetons.
- Raisonnement : Une fonction de réflexion avant la réponse, activable aux niveaux « low », « medium » et « high ». Elle peut être réglée à l'aide du paramètre
enable_thinking=falsese déconnecter complètement. - Données d'entraînement : L'origine des données d'entraînement est documentée. Toutes les données ont été vérifiées par rapport à une liste noire comprenant plus de 4,5 millions d'URL. Cette liste s'appuie notamment sur la « Piracy Watch List » de la Commission européenne. D'après la fiche descriptive du modèle, Aleph Alpha est par ailleurs signataire du Code de bonnes pratiques GPAI de l'UE.
En quoi un modèle européen de documents se distingue-t-il ?
Dans le cadre du traitement des documents, le modèle linguistique lit les factures, les contrats, les bulletins de paie et les relevés bancaires, c'est-à-dire des données soumises au RGPD et qui, dans de nombreuses entreprises, ne doivent pas quitter le réseau interne. Le modèle comparable Qwen3.5, également sous licence Apache 2.0, propose lui aussi un fonctionnement hors ligne et une licence libre. Ce qui distingue une solution européenne comme Kolibri-1, ce sont la juridiction du fournisseur et de l’entraînement, l’origine documentée des données et la proportion de textes en allemand dans l’entraînement. Ces avantages ne dépendent pas d’un fabricant ; Kolibri-1 est le modèle à l’aune duquel ils se sont mesurés. Voici ces quatre points en détail :
Les données restent en interne
Un modèle à poids ouverts fonctionne sur son propre matériel, et lors du test, Kolibri-1 a tourné entièrement hors ligne sur un ordinateur portable. Aucun document ni aucune valeur lue n'ont quitté la machine. C'est la réponse la plus concise à la question du traitement des commandes, car aucun prestataire de services n'intervient.
L'article consacré à ce sujet explique comment la Conférence sur la protection des données aborde cette question IA et protection des données. Les coûts liés au matériel et à l'exploitation d'un système sur ses propres serveurs sont détaillés dans l'article consacré à IA sur site.
Une licence sans seuils d'utilisation
Le site Licence Apache 2.0 accorde un droit d'utilisation „ perpétuel, mondial, non exclusif, gratuit et libre de droits “. L'utilisation commerciale est incluse ; il n'y a pas de seuils en termes de nombre d'utilisateurs ou de chiffre d'affaires.
Pour les entreprises, cela a deux conséquences : aucun fournisseur ne peut modifier a posteriori les conditions d'utilisation relatives aux poids publiés, et aucun point relatif à la licence ne reste en suspens lors d'un contrôle de diligence raisonnable. La fiche type précise que la licence ne couvre que les poids et les fichiers de configuration ; cela suffit pour l'exploitation au sein de l'entreprise.
L'allemand pour débutants
Aleph Alpha se distingue par Blog technique à publier des modèles qui apprennent l'allemand à partir de textes anglais traduits. Notre ambition est la suivante : „ bilingue par conception, et non un modèle anglais ayant lu un peu d’allemand “. À cela s’ajoute un tokeniseur optimisé pour l’allemand, c’est-à-dire la décomposition du texte en unités de calcul. Il représente les textes allemands avec moins de tokens, ce qui permet d’économiser du contexte et du temps de calcul.
Samuel Weinbach, cofondateur et co-directeur de la recherche, déclare dans le communiqué de presse : „ Nous avons spécialement adapté Kolibri aux besoins des applications germanophones. “
Un cadre juridique adapté à ses propres besoins
Selon le blog technique, la formation s'est déroulée „ sur des infrastructures situées en Allemagne et en Finlande, conformément au droit européen et allemand, sans aucun contrôle étranger “. Pour un utilisateur au sein de l’UE, cela signifie que le prestataire et le lieu de formation sont soumis au droit européen, et que le lieu d’exploitation est son propre domicile. Dans le cas de prestataires basés aux États-Unis ou en Chine, des questions relatives à la protection des données restent actuellement en suspens.
Le communiqué de presse mentionne également un accord conclu avec le fournisseur Cohere concernant la création d'une coentreprise transatlantique, sous réserve de l'obtention des autorisations nécessaires. Cela ne change rien aux pondérations publiées ni à leur licence, car les utilisateurs disposent déjà de ces deux éléments.
Comment le test était organisé
L'ensemble de test est le même que celui utilisé jusqu'à présent par Konfuzio pour comparer les modèles non validés : cinq types de documents financiers allemands. Il s'agit notamment de relevés de compte, de factures, de factures électroniques au format ZUGFeRD, d'attestations fiscales émises par les banques et de relevés de titres. Tous sont générés de manière synthétique ou proviennent d’exemples publics ; aucun ne contient de véritables données clients ou personnelles. Deux relevés de compte annuels comportant plusieurs centaines d’opérations ne sont pas pris en compte dans la comparaison des modèles ; les taux et les durées se rapportent aux 17 documents restants.
Pour chaque champ et chaque cellule du tableau, il existe une valeur de référence vérifiée manuellement, soit au total 159 champs individuels et 499 cellules du tableau. La tâche correspond à une situation courante liée au produit : le pipeline transmet au modèle le texte issu de la reconnaissance optique de caractères (OCR) ainsi que les instructions relatives aux champs fournies par l'extracteur. Le modèle remplit les champs, tels que le numéro de facture, les montants et le titulaire du compte, et lit chaque ligne d'un tableau de comptabilisation ou de postes.
Une valeur est considérée comme correcte si, une fois son orthographe harmonisée, elle correspond à la valeur de référence. Pour le texte des tableaux, une tolérance est appliquée aux sauts de ligne résultant de la reconnaissance de texte. Les deux modèles ont été traités le même jour sur la même machine via le même pipeline Konfuzio :
- Matériel : un MacBook Pro équipé d'un processeur M5 Pro et de 64 Go de mémoire vive, sans service cloud.
- Modèle de référence : Qwen3.5 35B-A3B d'Alibaba, le modèle ouvert qui a obtenu jusqu'à présent les meilleurs résultats sur cet ensemble de données.
- Quantification : Les deux modèles fonctionnaient avec une précision réduite au niveau des poids, afin de pouvoir tenir dans la mémoire. Kolibri-1 dans sa version 3 bits Q3_K_M occupe environ 37,5 Go, tandis que Qwen3.5, dans sa version 4 bits Q4_K_M, occupe environ 23 Go. Kolibri-1 était donc plus fortement compressé ; ses valeurs ont tendance ici à être plutôt trop basses que trop élevées.
- Raisonnement : désactivé sur Kolibri-1 ; plus d'informations à ce sujet ci-dessous.
- Environnement d'exécution : Le jour du test, Kolibri-1 n'était pas encore capable d'exécuter des outils courants tels qu'Ollama. C'est une version de llama.cpp adaptée par la communauté qui a été utilisée.
Les résultats
| Kolibri-1 (Aleph Alpha) | Qwen3.5 35B-A3B (Alibaba) | |
|---|---|---|
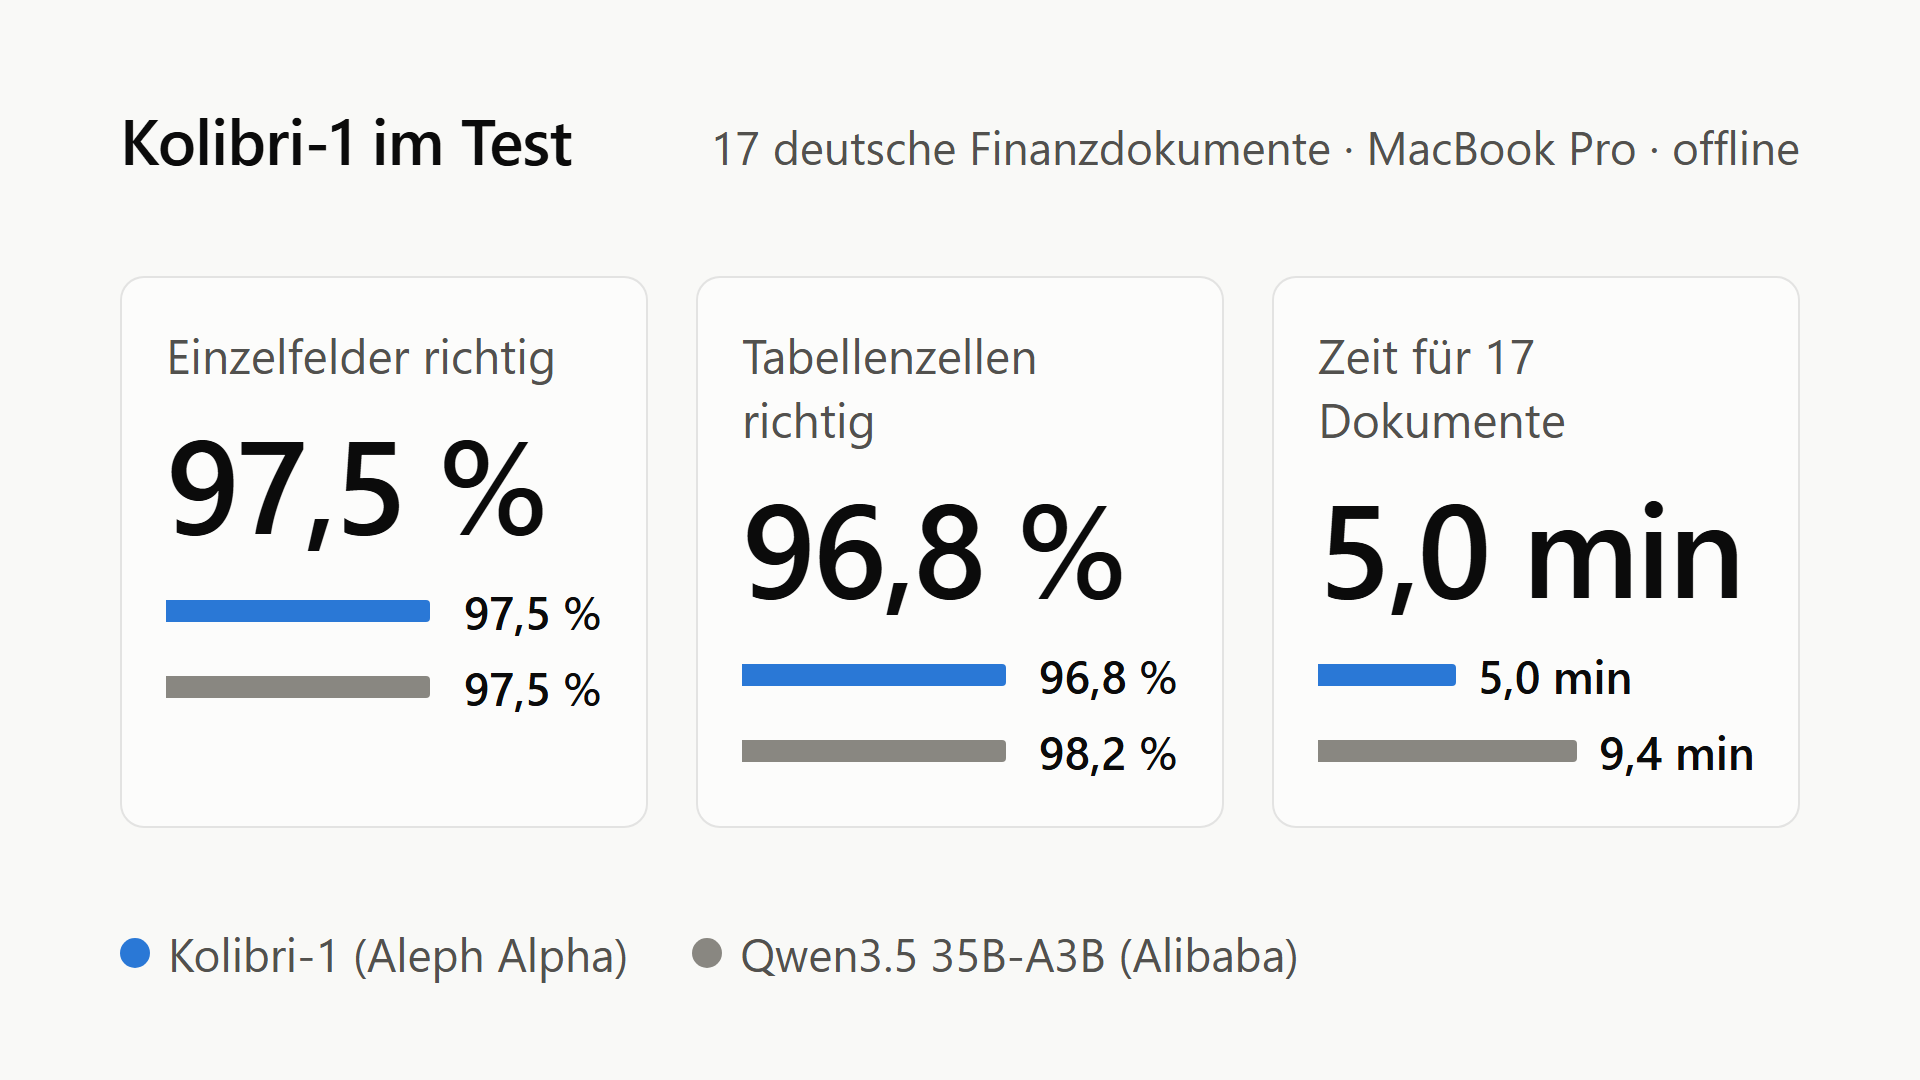
| Champs individuels corrects (159) | 97,5 % | 97,5 % |
| Cellules du tableau correctes (499) | 96,8 % | 98,2 % |
| Documents avec interruption (raisonnement désactivé) | 0 | 0 |
| Le temps nécessaire pour les 17 documents | 5,0 minutes | 9,4 minutes |
| Temps moyen par document | environ 18 secondes | environ 33 secondes |
En ce qui concerne les champs individuels, les deux modèles sont à égalité : chacun a lu correctement 155 champs sur 159. Pour les tableaux, Kolibri-1 se place juste derrière Qwen3.5, avec 96,8 % contre 98,2 %, soit un écart de sept cellules sur 499. En revanche, Kolibri-1 a mis 5,0 minutes au lieu de 9,4 minutes pour traiter l'ensemble des documents du test. Les documents simples d'une seule page, tels que les attestations fiscales, ont été traités en environ 10 secondes.
Ce que révèle le test
Même précision pour un temps de traitement environ deux fois plus court
L'écart de 1,4 point de pourcentage au niveau des cellules du tableau correspond à sept cellules sur 499. Seules plusieurs exécutions permettraient de déterminer s'il s'agit d'une différence entre les modèles ou d'une dispersion. La vitesse est plus évidente. Le test ne précise pas d’où elle provient : les deux modèles n’activent qu’environ trois milliards de paramètres par token. Les hypothèses possibles sont l’autre version de llama.cpp, une quantification plus forte et un tokeniseur plus dense pour l’allemand, ces trois éléments n’ayant pas encore été vérifiés.
Concrètement, cela signifie qu'un document contenant une cellule erronée doit être vérifié par quelqu'un. L'article consacré à ce sujet explique comment configurer cette étape de vérification dans un workflow : L'homme dans la boucle.
Désactiver le raisonnement
Lorsque la fonction de raisonnement était activée, Kolibri-1 s'est retrouvé plusieurs fois bloqué dans une boucle avec des documents courts et a dépassé la limite de temps. Sans raisonnement, chaque document a été traité environ trois fois plus vite, selon le rapport de test. Pour extraire des champs, un modèle n'a pas besoin de raisonner, car la réponse se trouve dans le document.
Les relevés bancaires détaillés restent la limite
Aucun des modèles testés jusqu'à présent n'est capable de lire intégralement, en un seul passage, les deux relevés bancaires annuels de 12 et 14 pages comportant plusieurs centaines d'opérations. Kolibri-1 a été le premier à fournir une partie d'un tel relevé. Selon Konfuzio, la solution est en cours de développement : les longs tableaux doivent être extraits par sections, et c'est ce à quoi l'on travaille actuellement.
Limites du test
- Contenu : 17 documents, tous en allemand, tous issus du domaine financier. Les autres types de documents et les autres langues n'ont pas été vérifiés.
- Quantification : Les deux modèles ont été exécutés en version compressée sur un ordinateur portable. Les versions en précision maximale sur un serveur n'ont pas été testées ; leurs résultats peuvent différer.
- Une course par modèle : Chaque chiffre provient d'un seul essai. Les légères différences peuvent être dues à la dispersion.
- Besoins en mémoire : Kolibri-1 nécessite environ 15 Go de mémoire vive de plus que le modèle de référence et tient tout juste sur un ordinateur portable de 64 Go. La fiche technique indique que, pour la version FP8 non compressée d'environ 78 Go, il faut au minimum deux cartes A100 de 80 Go chacune, deux cartes H100 ou une carte H200.
- Outils : La prise en charge dans Ollama et d'autres outils n'était pas encore disponible le jour du test. Cela évolue à chaque nouvelle version ; les valeurs indiquées ici correspondent à la situation au 12 octobre 2026.
Pour savoir ce que les tests de performance courants révèlent ou non sur un modèle, consultez l'article consacré à les benchmarks LLM courants. En matière de traitement des documents, rien ne remplace un jeu de tests spécifique avec des valeurs de référence.
Conclusion : ce que révèle ce test quant à une solution européenne
Kolibri-1 lit les documents financiers allemands avec une précision presque équivalente à celle du meilleur modèle open source sur le jeu de données de test Konfuzio, et ce à une vitesse environ deux fois supérieure. Il fonctionne sous une licence autorisant une utilisation commerciale sans seuil, sur une seule machine, et aucun document ne doit quitter l'entreprise. Dans cet ensemble de tests, c'est le premier modèle à combiner ces deux aspects : un fournisseur et des données d'entraînement situés dans l'espace juridique européen, et des performances équivalentes à celles du meilleur modèle open source.
Les limites sont les mêmes que pour tous les modèles : de longs tableaux qu'il faut parcourir section par section, et un ensemble d'outils qui n'est pas encore à la hauteur du modèle. Pour connaître les valeurs applicables à ses propres documents, il faut disposer de son propre ensemble de tests. Avec 17 documents et des valeurs de référence vérifiées, il a été possible de mesurer de manière fiable la précision et la vitesse.
En résumé, on peut retenir que, malgré les limites du test, les premiers résultats sont très encourageants. Kolibri-1 d'Aleph Alpha est un signal fort de l'Europe sur le marché de l'IA et peut constituer une véritable alternative, en particulier pour les entreprises pour lesquelles la conformité et la protection des données jouent un rôle majeur, car, contrairement à ses concurrents internationaux, le fournisseur est toujours soumis à la législation européenne.
AL'origine des données d'entraînement est documentée. Selon Communiqué de presse du 5 octobre 2026 Toutes les données ont été vérifiées par rapport à une liste noire comprenant plus de 4,5 millions d'URL. Cette liste s'appuie notamment sur la « Piracy Watch List » de la Commission européenne. D'après la carte conceptuelle, Aleph Alpha est par ailleurs signataire du Code de bonnes pratiques GPAI de l'UE.
Kolibiri-1 peut également être intégré aux solutions de Konfuzio. N'hésitez donc pas à nous contacter si ce sujet vous intéresse ou si vous avez des questions à ce sujet.

 FR
 DE
 EN
 ES