
Am 3. Oktober 2026 hat Aleph Alpha Kolibri-1 veröffentlicht: ein großes Sprachmodell (LLM, Large Language Model) als Open-Weight-Modell. Bedeutet: Mit trainierten Gewichten, die frei herunterladbar sind und unter Apache-2.0-Lizenz auf eigener Hardware laufen. Es stammt vom Heidelberger Unternehmen Aleph Alpha und wurde auf Rechnern in Deutschland und Finnland trainiert. Für Unternehmen, die Wert auf Anbieter und Lösungen aus dem europäischen Rechtsraum legen, kann Kolibri-1 daher eine interessante Option darstellen.
Ob das Modell Rechnungen, Kontoauszüge und Steuerbescheinigungen auch zuverlässig liest, hat Konfuzio am 12. Oktober in einem kleinen Testlauf geprüft, um eine erste praktische Einschätzung über das deutsche Modell zu erhalten. Der Test lief auf 17 deutschen Finanzdokumenten und durch dieselbe Konfuzio-Pipeline wie das bisher beste offene Modell im Konfuzio-Testsatz. Dieser Beitrag beschreibt, was Kolibri-1 ist und worin sich ein europäisches Modell für Dokumentenprozesse von anderen offenen Modellen unterscheidet. Am Ende stellen wir unser Testergebnis vor und zeigen auf, wo Kolibri konkurrenzfähig ist und an welchen Stellen das Modell noch scheitert.
Was ist Kolibri-1?
- Herkunft: Entwickelt von der Aleph Alpha Research GmbH, veröffentlicht am 3. Oktober 2026. Die Gruppe hat ihren Hauptsitz in Heidelberg.
- Lizenz: Apache 2.0 für die Gewichte und Konfigurationsdateien. Code, Architektur und Trainingsmethoden sind laut Modellkarte ausdrücklich nicht Teil der Lizenz.
- Aufbau: Mixture of Experts, also ein Modell aus vielen Teilnetzen, von denen je Textbaustein (Token) nur wenige rechnen. Insgesamt 78 Milliarden Parameter, etwa 3,46 Milliarden aktiv je Token. Das Modell ist damit groß im Speicher, aber schnell in der Ausführung.
- Sprachen: Deutsch und Englisch. Im Pre-Training auf 20 Billionen Token lag der deutsche Anteil bei rund 23,9 Prozent, der englische bei 62,5 Prozent, Code bei 13,6 Prozent.
- Kontext: bis zu 1.048.576 Token, empfohlen sind höchstens 262.144 Token.
- Reasoning: Ein zuschaltbares Nachdenken vor der Antwort in den Stufen low, medium und high. Es lässt sich mit der Einstellung
enable_thinking=falseganz abschalten. - Trainingsdaten: Die Herkunft der Trainingsdaten ist dokumentiert. Alle Daten wurden gegen eine Sperrliste mit mehr als 4,5 Millionen URLs geprüft. Diese Liste beruht unter anderem auf der Piracy Watch List der Europäischen Kommission. Laut Modellkarte ist Aleph Alpha zudem Unterzeichner des GPAI Code of Practice der EU.
Worin unterscheidet sich ein europäisches Modell bei Dokumenten?
Bei der Dokumentenverarbeitung liest das Sprachmodell Rechnungen, Verträge, Gehaltsabrechnungen und Kontoauszüge, also Daten, für die die DSGVO gilt und die in vielen Häusern das eigene Netz nicht verlassen dürfen. Offline-Betrieb und eine freie Lizenz bietet auch das Vergleichsmodell Qwen3.5, das ebenfalls unter Apache 2.0 steht. Was eine europäische Lösung wie Kolibri-1 davon unterscheidet, sind der Rechtsraum von Anbieter und Training, die dokumentierte Datenherkunft und der Anteil deutscher Texte im Training. Diese Vorteile hängen nicht an einem Hersteller; Kolibri-1 ist das Modell, an dem sie sich messen ließen. Die vier Punkte im Einzelnen:
Die Daten bleiben im Haus
Ein Modell mit offenen Gewichten läuft auf eigener Hardware, und im Test lief Kolibri-1 vollständig offline auf einem Laptop. Kein Dokument und kein ausgelesener Wert hat die Maschine verlassen. Dies beantwortet die Frage nach der Auftragsverarbeitung am kürzesten, weil kein Dienstleister beteiligt ist.
Wie die Datenschutzkonferenz diese Frage stellt, beschreibt der Beitrag zu KI und Datenschutz. Was ein Betrieb auf eigenen Servern an Hardware und Betrieb kostet, steht im Beitrag zu On-Premise AI.
Eine Lizenz ohne Nutzungsschwellen
Die Lizenz Apache 2.0 räumt ein „perpetual, worldwide, non-exclusive, no-charge, royalty-free“ Nutzungsrecht ein. Kommerzielle Nutzung ist eingeschlossen, Schwellen für Nutzerzahlen oder Umsatz gibt es keine.
Für Unternehmen hat das zwei Folgen: Kein Anbieter kann die Nutzungsbedingungen für die veröffentlichten Gewichte später ändern, und bei einer Due-Diligence-Prüfung bleibt keine Lizenzfrage offen. Die Modellkarte weist darauf hin, dass die Lizenz nur die Gewichte und Konfigurationsdateien deckt; für den Betrieb im Unternehmen reicht das aus.
Deutsch von Grund auf
Aleph Alpha grenzt sich im Technik-Blog zur Veröffentlichung von Modellen ab, die Deutsch über übersetzte englische Texte lernen. Der eigene Anspruch lautet: „bilingual by design, not an English model that has read some German“. Dazu kommt ein auf Deutsch optimierter Tokenizer, also die Zerlegung des Textes in Recheneinheiten. Er bildet deutsche Texte mit weniger Token ab, was Kontext und Rechenzeit spart.
Samuel Weinbach, Mitgründer und Co-Chief Research Officer, sagt in der Pressemitteilung: „Wir haben Kolibri speziell auf die Anforderungen deutschsprachiger Anwendungen zugeschnitten.“
Ein Rechtsrahmen, der zum eigenen passt
Trainiert wurde laut Technik-Blog „on infrastructure in Germany and Finland, under European and German law, with no foreign control“. Für einen Anwender in der EU heißt das: Anbieter und Trainingsort unterliegen europäischem Recht, und der Betriebsort ist das eigene Haus. Bei Anbietern aus den USA oder China bleiben aktuell immer datenschutzrechtliche Fragen offen.
Die Pressemitteilung nennt außerdem eine Vereinbarung mit dem Anbieter Cohere über ein gemeinsames transatlantisches Unternehmen, vorbehaltlich der Genehmigungen. Die veröffentlichten Gewichte und ihre Lizenz ändert das nicht, denn beides liegt bereits bei den Anwendern.
Wie der Test aufgebaut war
Der Testsatz ist derselbe, mit dem Konfuzio bisher offene Modelle vergleicht: deutsche Finanzdokumente in fünf Arten. Dazu gehören Kontoauszüge, Rechnungen, elektronische Rechnungen im ZUGFeRD-Format, Steuerbescheinigungen von Banken und Wertpapierabrechnungen. Alle sind synthetisch erzeugt oder öffentliche Muster; keines enthält echte Kunden- oder Personendaten. Zwei Jahreskontoauszüge mit mehreren hundert Buchungen bleiben beim Modellvergleich außen vor; die Quoten und Zeiten beziehen sich auf die übrigen 17 Dokumente.
Für jedes Feld und jede Tabellenzelle gibt es einen von Hand geprüften Sollwert, insgesamt 159 Einzelfelder und 499 Tabellenzellen. Die Aufgabe entspricht dem Produktalltag: Die Pipeline übergibt dem Modell den Text aus der Texterkennung (OCR, Optical Character Recognition) und die Feldanweisungen des Extraktors. Das Modell füllt die Felder, etwa Rechnungsnummer, Beträge und Kontoinhaber, und liest jede Zeile einer Buchungs- oder Positionstabelle.
Als richtig zählt ein Wert, der nach dem Vereinheitlichen der Schreibweise dem Sollwert entspricht. Bei Tabellentext gilt eine Toleranz für Zeilenumbrüche aus der Texterkennung. Beide Modelle liefen am selben Tag auf derselben Maschine durch dieselbe Konfuzio-Pipeline:
- Hardware: ein MacBook Pro mit M5 Pro und 64 GB Arbeitsspeicher, ohne Cloud-Dienst.
- Vergleichsmodell: Qwen3.5 35B-A3B von Alibaba, das offene Modell mit den bisher besten Ergebnissen in diesem Testsatz.
- Quantisierung: Beide Modelle liefen mit verringerter Genauigkeit der Gewichte, damit sie in den Speicher passen. Kolibri-1 in der 3-Bit-Fassung Q3_K_M mit etwa 37,5 GB, Qwen3.5 in der 4-Bit-Fassung Q4_K_M mit etwa 23 GB. Kolibri-1 war damit stärker komprimiert; seine Werte fallen hier eher zu niedrig als zu hoch aus.
- Reasoning: bei Kolibri-1 abgeschaltet, dazu unten mehr.
- Laufzeitumgebung: Gängige Werkzeuge wie Ollama konnten Kolibri-1 am Testtag noch nicht ausführen. Zum Einsatz kam eine von der Community angepasste Version von llama.cpp.
Die Ergebnisse
| Kolibri-1 (Aleph Alpha) | Qwen3.5 35B-A3B (Alibaba) | |
|---|---|---|
| Einzelfelder richtig (159) | 97,5 % | 97,5 % |
| Tabellenzellen richtig (499) | 96,8 % | 98,2 % |
| Dokumente mit Abbruch (Reasoning aus) | 0 | 0 |
| Zeit für alle 17 Dokumente | 5,0 Minuten | 9,4 Minuten |
| Zeit je Dokument im Schnitt | etwa 18 Sekunden | etwa 33 Sekunden |
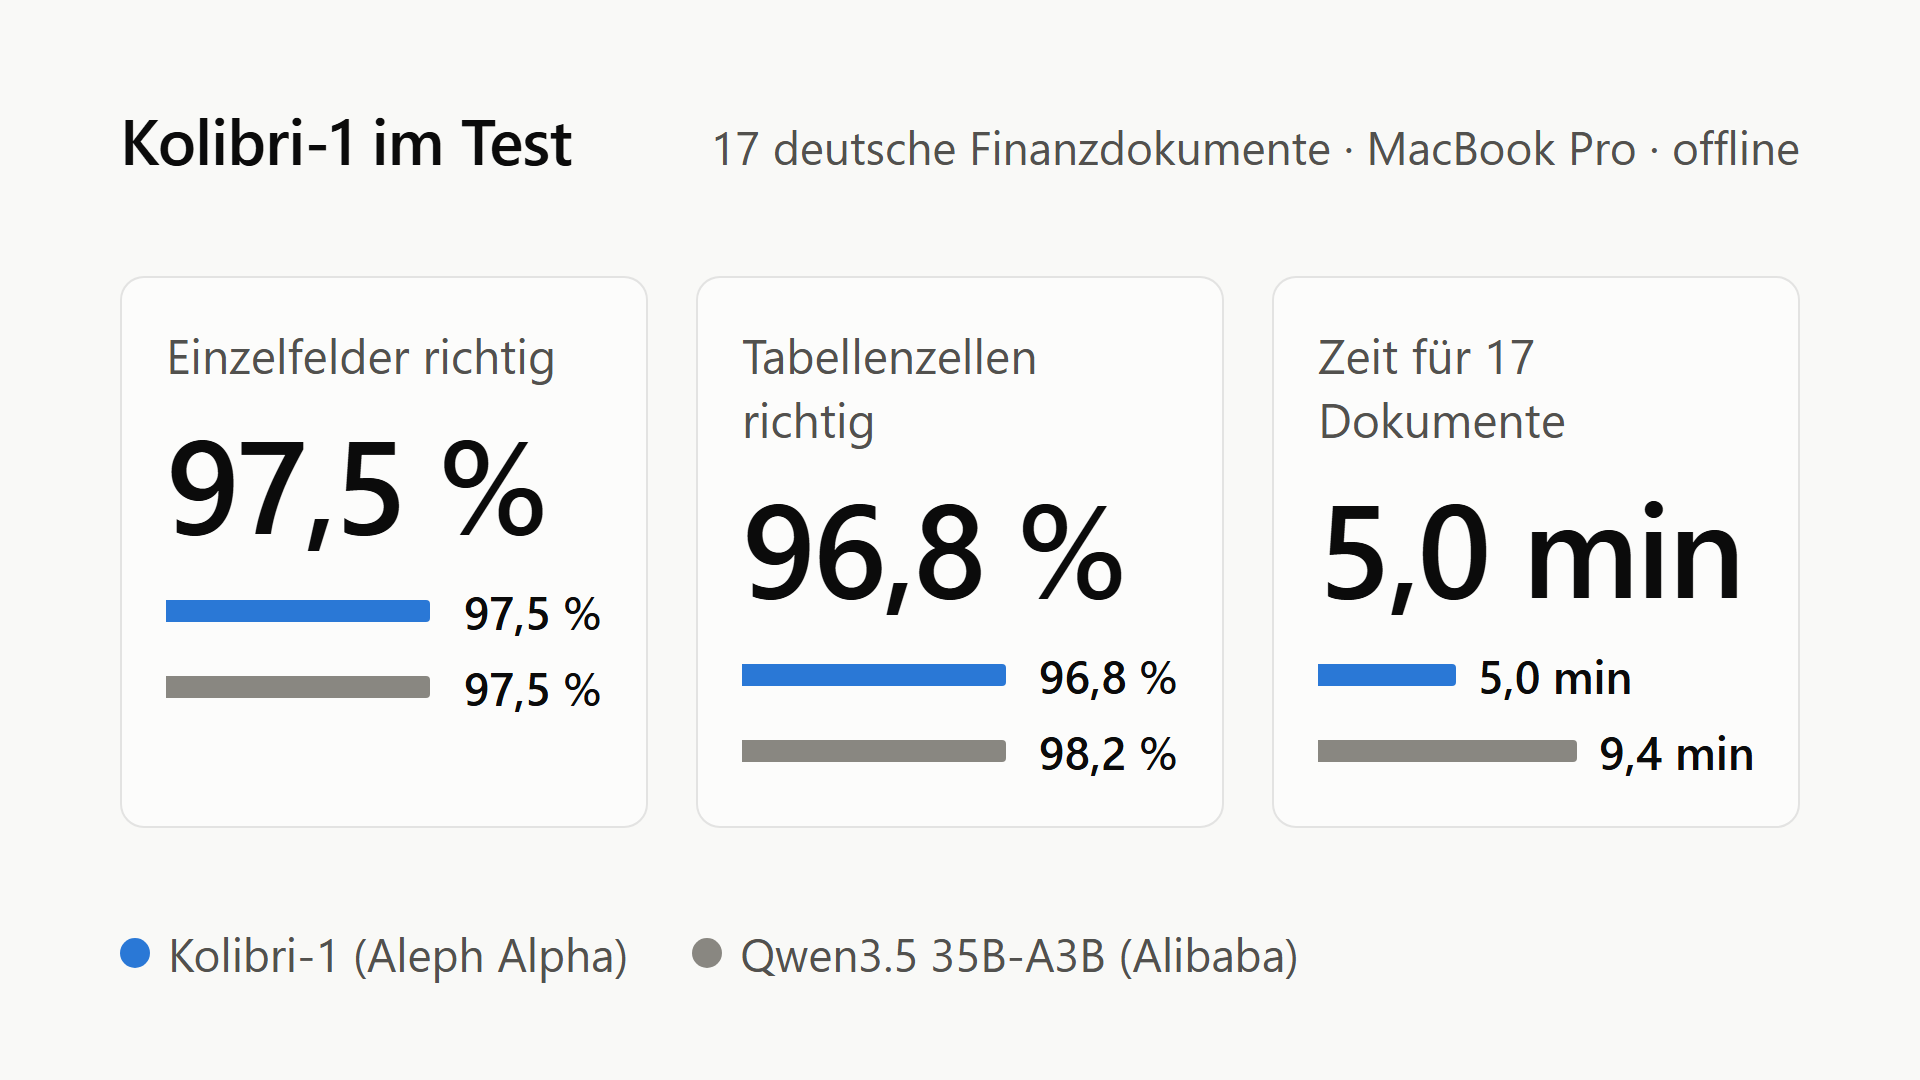
Bei den Einzelfeldern liegen beide Modelle gleichauf: Jedes las 155 von 159 Feldern richtig. Bei den Tabellen liegt Kolibri-1 mit 96,8 Prozent knapp hinter Qwen3.5 mit 98,2 Prozent, das sind sieben Zellen von 499. Dafür brauchte Kolibri-1 für den gesamten Testsatz 5,0 Minuten statt 9,4 Minuten. Einfache einseitige Dokumente wie Steuerbescheinigungen waren in rund 10 Sekunden fertig.
Was der Test zeigt
Gleiche Genauigkeit bei etwa halber Laufzeit
Die 1,4 Prozentpunkte Abstand bei den Tabellenzellen entsprechen sieben Zellen von 499. Ob das ein Unterschied zwischen den Modellen oder Streuung ist, ließe sich erst mit mehreren Läufen sagen. Deutlicher ist das Tempo. Woher es kommt, zeigt der Test nicht: Beide Modelle aktivieren je Token nur rund drei Milliarden Parameter. Kandidaten sind der andere llama.cpp-Build, die stärkere Quantisierung und der für Deutsch dichtere Tokenizer, alle drei ungeprüft.
Für die Praxis heißt das: Ein Dokument, in dem eine Zelle falsch ist, muss jemand prüfen. Wie dieser Prüfschritt in einem Workflow eingestellt wird, beschreibt der Beitrag zu Human in the Loop.
Reasoning abschalten
Mit eingeschaltetem Nachdenken blieb Kolibri-1 bei kurzen Dokumenten mehrfach in einer Schleife hängen und lief in die Zeitgrenze. Ohne Reasoning wurde jedes Dokument verarbeitet, laut Testbericht etwa dreimal so schnell. Für das Auslesen von Feldern braucht ein Modell kein Nachdenken, weil die Antwort im Dokument steht.
Lange Kontoauszüge bleiben die Grenze
Die zwei Jahreskontoauszüge mit 12 und 14 Seiten und mehreren hundert Buchungen liest kein bisher getestetes Modell in einem Aufruf vollständig. Kolibri-1 war das erste, das einen Teil eines solchen Auszugs lieferte. Die Lösung liegt nach Einschätzung von Konfuzio in der Pipeline: Lange Tabellen müssen abschnittsweise extrahiert werden, daran wird gearbeitet.
Grenzen des Tests
- Umfang: 17 Dokumente, alle deutsch, alle aus dem Finanzbereich. Andere Dokumentarten und Sprachen wurden nicht geprüft.
- Quantisierung: Beide Modelle liefen komprimiert auf einem Laptop. Versionen in voller Genauigkeit auf einem Server wurden nicht getestet; ihre Ergebnisse können abweichen.
- Ein Lauf je Modell: Jede Zahl stammt aus einem einzelnen Durchlauf. Kleine Unterschiede können Streuung sein.
- Speicherbedarf: Kolibri-1 braucht rund 15 GB mehr Arbeitsspeicher als das Vergleichsmodell und passt auf einen 64-GB-Laptop gerade so. Die Modellkarte nennt für die unkomprimierte FP8-Fassung von rund 78 GB als Minimum zwei A100-Karten mit je 80 GB, zwei H100 oder eine H200.
- Werkzeuge: Die Unterstützung in Ollama und anderen Werkzeugen stand am Testtag noch aus. Das ändert sich mit jeder Version, die Werte hier beschreiben den Stand vom 12. Oktober 2026.
Was gängige Benchmarks über ein Modell aussagen und was nicht, steht im Beitrag zu gängigen LLM-Benchmarks. Für die Dokumentenverarbeitung ersetzt nichts einen eigenen Testsatz mit Sollwerten.
Fazit: Was der Test für eine europäische Lösung zeigt
Kolibri-1 liest deutsche Finanzdokumente nahezu so genau wie das beste offene Modell im Konfuzio-Testsatz, und etwa doppelt so schnell. Es läuft unter einer Lizenz, die kommerzielle Nutzung ohne Schwellen erlaubt, auf einer einzelnen Maschine, und kein Dokument muss das Unternehmen verlassen. In diesem Testsatz ist es das erste Modell, das beides verbindet: Anbieter und Trainingsdaten im europäischen Rechtsraum und Werte auf dem Niveau des besten offenen Modells.
Die Grenzen sind dieselben wie bei allen Modellen: lange Tabellen, die abschnittsweise gelesen werden müssen, und eine Werkzeuglandschaft, die dem Modell noch hinterherläuft. Wer die Werte für eigene Dokumente wissen will, braucht einen eigenen Testsatz. Mit 17 Dokumenten und geprüften Sollwerten ließen sich Genauigkeit und Tempo hier belastbar messen.
Zusammenfassend lässt sich als festhalten: Trotz der Grenzen des Tests, sind die ersten Anzeichen sehr positiv. Kolibri-1 von Aleph Alpha ist ein starkes europäisches Signal im KI-Markt und kann besonders für Unternehmen, für die Compliance und Datenschutz eine große Rolle spielen, eine echte Alternative sein, da der Anbieter im Gegensatz zur internationalen Konkurrenz stets an europäisches Recht gebunden ist.
ADie Herkunft der Trainingsdaten ist dokumentiert. Laut Pressemitteilung vom 5. Oktober 2026 wurden alle Daten gegen eine Sperrliste mit mehr als 4,5 Millionen URLs geprüft. Diese Liste beruht unter anderem auf der Piracy Watch List der Europäischen Kommission. Laut Modellkarte ist Aleph Alpha zudem Unterzeichner des GPAI Code of Practice der EU.
Auch in die Lösungen von Konfuzio kann Kolibiri-1 integriert werden. Sprechen Sie uns daher gerne an, wenn Sie Interesse oder Fragen zu dem Thema haben.

 DE
 EN
 ES
 FR