
El 3 de octubre de 2026, Aleph Alpha lanzó Kolibri-1: un modelo de lenguaje a gran escala (LLM, Large Language Model) como modelo de peso abierto. Esto significa que cuenta con pesos entrenados que se pueden descargar gratuitamente y que se ejecutan en hardware propio bajo la licencia Apache 2.0. Ha sido desarrollado por la empresa Aleph Alpha, con sede en Heidelberg, y se ha entrenado en servidores ubicados en Alemania y Finlandia. Por lo tanto, Kolibri-1 puede suponer una opción interesante para aquellas empresas que dan prioridad a los proveedores y las soluciones del espacio jurídico europeo.
El 12 de octubre, Konfuzio comprobó en una pequeña prueba si el modelo lee de forma fiable facturas, extractos bancarios y certificados fiscales, con el fin de obtener una primera valoración práctica del modelo alemán. La prueba se llevó a cabo con 17 documentos financieros alemanes y mediante el mismo proceso de Konfuzio que el mejor modelo abierto hasta la fecha en el conjunto de pruebas de Konfuzio. Este artículo describe qué es Kolibri-1 y en qué se diferencia un modelo europeo para el procesamiento de documentos de otros modelos abiertos. Al final, presentamos los resultados de nuestras pruebas y señalamos en qué aspectos Kolibri es competitivo y en cuáles el modelo aún presenta fallos.
¿Qué es Kolibri-1?
- Origen: Desarrollado por Aleph Alpha Research GmbH, publicado el 3 de octubre de 2026. El grupo tiene su sede en Heidelberg.
- Licencia: Apache 2.0 para los pesos y los archivos de configuración. Según la ficha del modelo, el código, la arquitectura y los métodos de entrenamiento quedan expresamente excluidos de la licencia.
- Estructura: «Mixture of Experts», es decir, un modelo compuesto por numerosas subredes, de las cuales solo unas pocas realizan cálculos por cada fragmento de texto (token). Un total de 78 000 millones de parámetros, de los cuales unos 3 460 millones están activos por cada token. Por lo tanto, el modelo ocupa mucho espacio en la memoria, pero es rápido en la ejecución.
- Idiomas: Alemán e inglés. En la fase previa al entrenamiento, con 20 billones de tokens, la proporción en alemán fue de alrededor del 23,9 %, la del inglés, del 62,5 %, y la del código, del 13,6 %.
- Contexto: hasta 1.048.576 tokens; se recomienda un máximo de 262.144 tokens.
- Razonamiento: Una función de reflexión antes de responder, que se puede activar en los niveles «low», «medium» y «high». Se puede configurar mediante el ajuste
enable_thinking=falsedesconectar por completo. - Datos del entrenamiento: Se ha documentado el origen de los datos de entrenamiento. Todos los datos se han cotejado con una lista de bloqueo que contiene más de 4,5 millones de URL. Esta lista se basa, entre otras cosas, en la «Piracy Watch List» de la Comisión Europea. Según el mapa del modelo, Aleph Alpha es además signatario del Código de prácticas GPAI de la UE.
¿En qué se diferencia un modelo europeo en lo que respecta a los documentos?
En el procesamiento de documentos, el modelo de lenguaje lee facturas, contratos, nóminas y extractos bancarios, es decir, datos a los que se aplica el RGPD y que, en muchas empresas, no pueden salir de la red interna. El modelo comparable Qwen3.5, que también está bajo licencia Apache 2.0, ofrece funcionamiento sin conexión y una licencia gratuita. Lo que distingue a una solución europea como Kolibri-1 son el marco jurídico del proveedor y del entrenamiento, el origen documentado de los datos y la proporción de textos en alemán en el entrenamiento. Estas ventajas no dependen de un fabricante concreto; Kolibri-1 es el modelo con el que se comparan. Los cuatro puntos en detalle:
Los datos se quedan en la empresa
Un modelo con pesos abiertos se ejecuta en hardware propio y, en la prueba, Kolibri-1 funcionó completamente sin conexión en un ordenador portátil. Ningún documento ni ningún valor leído salió de la máquina. Esto responde de la forma más concisa a la pregunta sobre el tratamiento por encargo, ya que no interviene ningún proveedor de servicios.
El artículo sobre cómo plantea esta cuestión la Conferencia de Protección de Datos describe... IA y protección de datos. Los costes de hardware y mantenimiento que supone para una empresa el funcionamiento en sus propios servidores se detallan en el artículo sobre IA local.
Una licencia sin límites de uso
En Licencia Apache 2.0 concede un derecho de uso „perpetuo, mundial, no exclusivo, gratuito y libre de derechos de autor“. Se incluye el uso comercial; no hay límites en cuanto al número de usuarios ni a la facturación.
Para las empresas, esto tiene dos consecuencias: ningún proveedor puede modificar posteriormente las condiciones de uso de los pesos publicados y, en caso de una auditoría de diligencia debida, no queda ninguna cuestión pendiente en materia de licencias. La ficha del modelo indica que la licencia solo cubre los pesos y los archivos de configuración; esto es suficiente para su uso en la empresa.
Alemán desde cero
Aleph Alpha se distingue en el Blog técnico para su publicación de modelos que aprenden alemán a partir de textos traducidos del inglés. Su propio lema es: „bilingüe por diseño, no un modelo en inglés que haya leído algo de alemán“. A esto se suma un tokenizador optimizado para el alemán, es decir, la división del texto en unidades de cálculo. Representa los textos en alemán con menos tokens, lo que ahorra contexto y tiempo de cálculo.
Samuel Weinbach, cofundador y codirector de investigación, afirma en el comunicado de prensa: „Hemos adaptado Kolibri específicamente a las necesidades de las aplicaciones en lengua alemana“.“
Un marco jurídico que se adapte a las propias necesidades
Según el blog técnico, la formación se impartió „en infraestructuras de Alemania y Finlandia, bajo la legislación europea y alemana, sin control extranjero“. Para un usuario de la UE, esto significa que tanto el proveedor como el lugar donde se imparte la formación están sujetos a la legislación europea, y que el lugar de uso es su propio domicilio. En el caso de los proveedores de EE. UU. o China, actualmente siguen sin resolverse cuestiones relacionadas con la protección de datos.
El comunicado de prensa menciona además un acuerdo con el proveedor Cohere para crear una empresa transatlántica conjunta, sujeto a la obtención de las autorizaciones pertinentes. Esto no afecta a los pesos publicados ni a su licencia, ya que ambos ya están en manos de los usuarios.
Cómo se estructuró la prueba
El conjunto de datos de prueba es el mismo que Konfuzio ha utilizado hasta ahora para comparar modelos abiertos: documentos financieros alemanes de cinco tipos diferentes. Entre ellos se incluyen extractos bancarios, facturas, facturas electrónicas en formato ZUGFeRD, certificados fiscales de bancos y extractos de valores. Todos ellos son documentos generados sintéticamente o modelos públicos; ninguno contiene datos reales de clientes ni datos personales. Dos extractos de cuenta anuales con varios cientos de movimientos no se tienen en cuenta en la comparación de modelos; las proporciones y los tiempos se refieren a los 17 documentos restantes.
Para cada campo y cada celda de la tabla hay un valor teórico comprobado manualmente; en total, 159 campos individuales y 499 celdas de la tabla. La tarea se corresponde con el día a día del producto: El proceso transmite al modelo el texto procedente del reconocimiento óptico de caracteres (OCR) y las instrucciones de los campos del extractor. El modelo rellena los campos —como el número de factura, los importes y el titular de la cuenta— y lee cada línea de una tabla de asientos o de partidas.
Se considera correcto aquel valor que, tras unificar la ortografía, coincida con el valor de referencia. En el caso del texto de las tablas, se aplica una tolerancia para los saltos de línea derivados del reconocimiento de texto. Ambos modelos se procesaron el mismo día en la misma máquina a través del mismo canal Konfuzio:
- Hardware: Un MacBook Pro con M5 Pro y 64 GB de memoria RAM, sin servicio en la nube.
- Modelo de referencia: Qwen3.5 35B-A3B de Alibaba, el modelo abierto que ha obtenido los mejores resultados hasta ahora en este conjunto de pruebas.
- Cuantización: Ambos modelos se ejecutaban con una precisión reducida de los pesos para que cupieran en la memoria. Kolibri-1, en la versión de 3 bits Q3_K_M, ocupaba unos 37,5 GB, mientras que Qwen3.5, en la versión de 4 bits Q4_K_M, ocupaba unos 23 GB. Por lo tanto, Kolibri-1 estaba más comprimido; sus valores tienden aquí a ser más bajos que altos.
- Razonamiento: desactivado en Kolibri-1; más información al respecto a continuación.
- Entorno de ejecución: El día de la prueba, Kolibri-1 aún no podía ejecutar herramientas habituales como Ollama. Se utilizó una versión de llama.cpp adaptada por la comunidad.
Los resultados
| Kolibri-1 (Aleph Alpha) | Qwen3.5 35B-A3B (Alibaba) | |
|---|---|---|
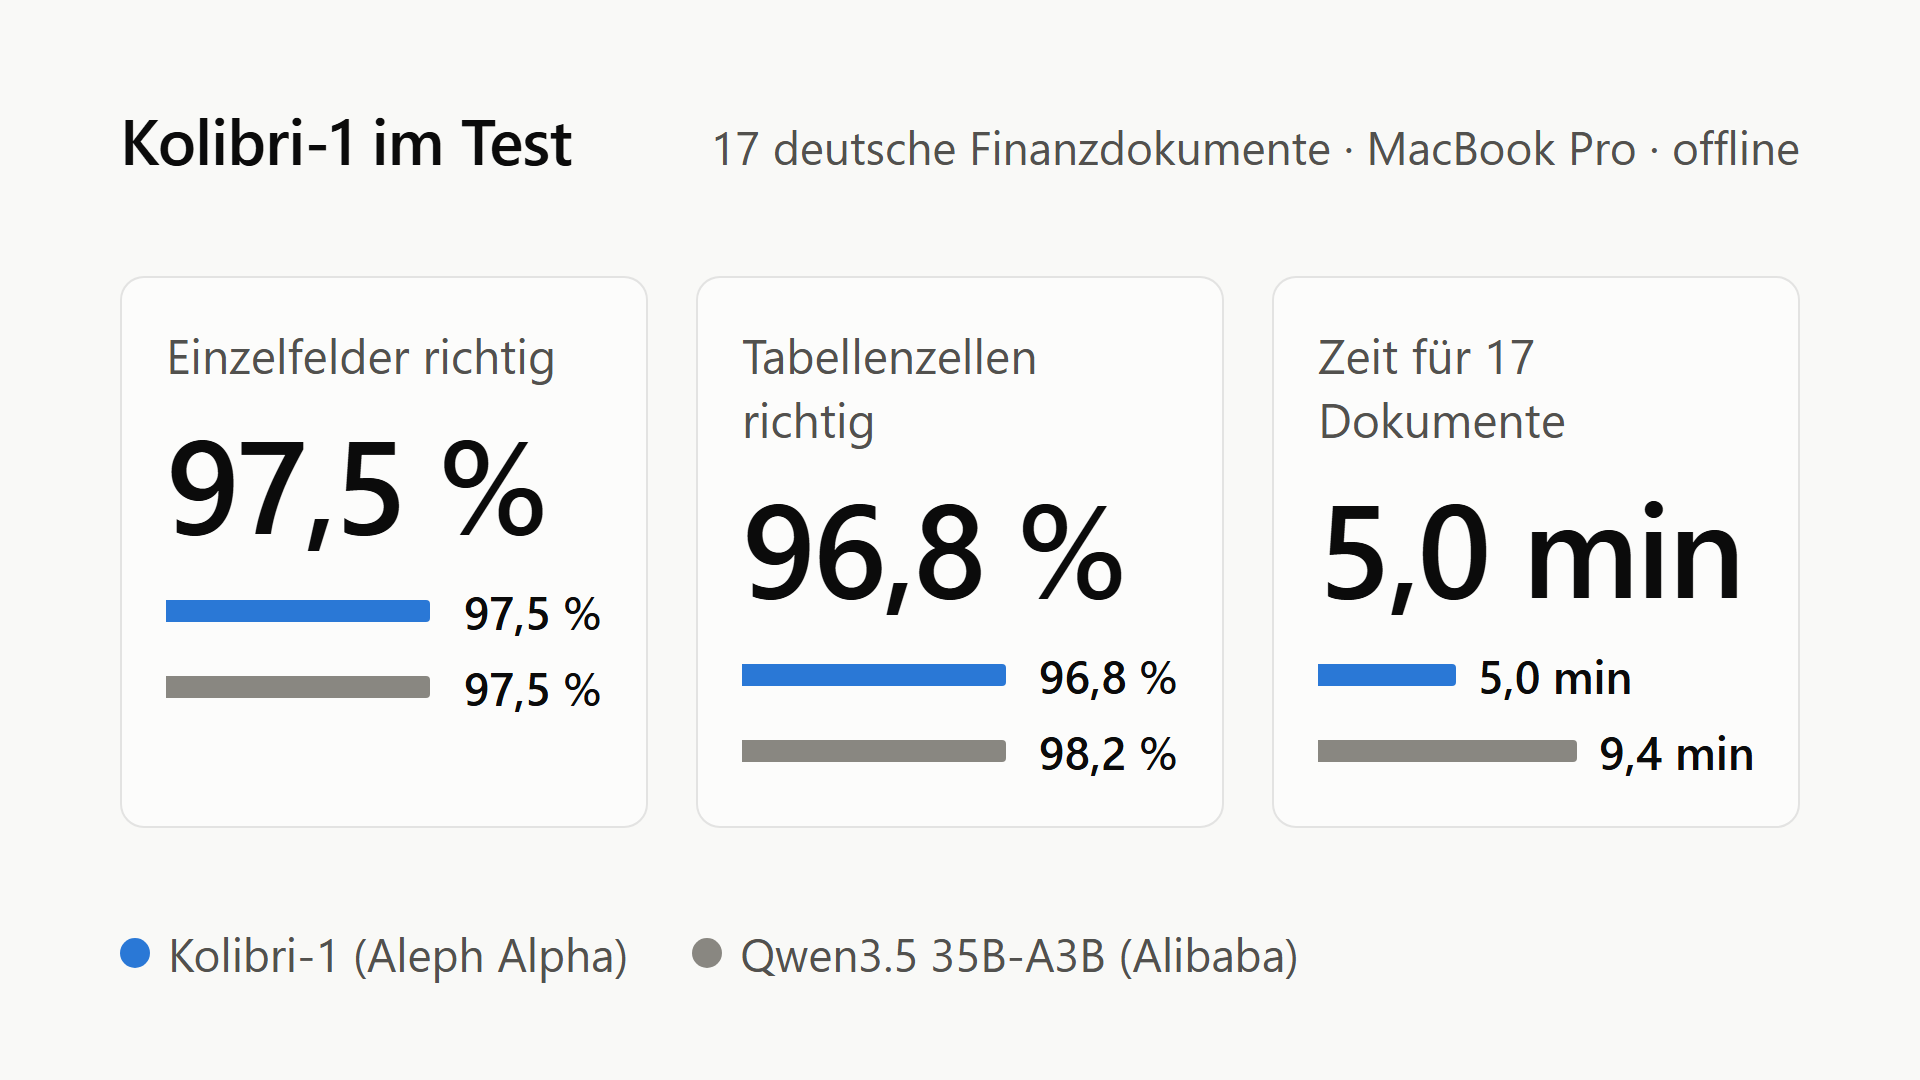
| Campos individuales correctos (159) | 97,5 % | 97,5 % |
| Celdas de la tabla correctas (499) | 96,8 % | 98,2 % |
| Documentos con interrupción (razonamiento desactivado) | 0 | 0 |
| Tiempo para los 17 documentos | 5,0 minutos | 9,4 minutos |
| Tiempo medio por documento | unos 18 segundos | unos 33 segundos |
En cuanto a los campos individuales, ambos modelos están empatados: cada uno leyó correctamente 155 de 159 campos. En el caso de las tablas, Kolibri-1, con un 96,8 %, se sitúa ligeramente por detrás de Qwen3.5, con un 98,2 %; esto supone una diferencia de siete celdas de un total de 499. Sin embargo, Kolibri-1 tardó 5,0 minutos en procesar todo el conjunto de pruebas, en lugar de los 9,4 minutos. Los documentos sencillos de una sola página, como los certificados fiscales, se procesaron en unos 10 segundos.
Lo que revela la prueba
La misma precisión con aproximadamente la mitad del tiempo de ejecución
La diferencia de 1,4 puntos porcentuales en las celdas de la tabla equivale a siete celdas de 499. Solo tras realizar varias ejecuciones se podría determinar si se trata de una diferencia entre los modelos o de una dispersión. Lo que resulta más evidente es la velocidad. La prueba no revela a qué se debe: ambos modelos activan solo unos tres mil millones de parámetros por token. Las posibles causas podrían ser la otra compilación de llama.cpp, una cuantificación más intensa y un tokenizador más denso para el alemán, aunque ninguna de estas tres hipótesis se ha comprobado.
En la práctica, esto significa que alguien debe revisar un documento en el que haya una celda con un error. En el artículo sobre Humano en el bucle.
Desactivar el razonamiento
Con la función de razonamiento activada, Kolibri-1 se quedó atascado varias veces en un bucle con documentos cortos y superó el límite de tiempo. Sin la función de razonamiento, se procesó cada documento aproximadamente tres veces más rápido, según el informe de pruebas. Para extraer datos de los campos, un modelo no necesita razonar, ya que la respuesta se encuentra en el propio documento.
Los extractos bancarios largos siguen siendo el límite
Ninguno de los modelos probados hasta ahora es capaz de leer íntegramente en una sola ejecución los dos extractos bancarios anuales de 12 y 14 páginas, con varios cientos de movimientos. Kolibri-1 fue el primero en proporcionar una parte de uno de esos extractos. Según la valoración de Konfuzio, la solución está en camino: las tablas largas deben extraerse por secciones, y se está trabajando en ello.
Límites de la prueba
- Extensión: 17 documentos, todos en alemán, todos del ámbito financiero. No se han revisado otros tipos de documentos ni otros idiomas.
- Cuantización: Ambos modelos se ejecutaron en formato comprimido en un ordenador portátil. No se han probado las versiones con precisión completa en un servidor; sus resultados pueden variar.
- Una serie por modelo: Cada cifra procede de una sola prueba. Las pequeñas diferencias pueden deberse a la dispersión.
- Requisitos de almacenamiento: Kolibri-1 necesita unos 15 GB más de memoria RAM que el modelo de referencia y cabe por los pelos en un portátil de 64 GB. La ficha técnica del modelo indica que, para la versión FP8 sin comprimir de unos 78 GB, se necesitan como mínimo dos tarjetas A100 de 80 GB cada una, dos H100 o una H200.
- Herramientas: El día de la prueba aún no se disponía de compatibilidad con Ollama ni con otras herramientas. Esto cambia con cada versión; los valores que aquí se indican corresponden a la situación a fecha de 12 de octubre de 2026.
Lo que revelan y lo que no revelan las pruebas de rendimiento habituales sobre un modelo se explica en el artículo sobre pruebas de rendimiento habituales de los modelos LLM. Para el procesamiento de documentos, nada sustituye a un conjunto de pruebas propio con valores de referencia.
Conclusión: lo que revela la prueba sobre una solución europea
Kolibri-1 lee documentos financieros alemanes con una precisión casi igual a la del mejor modelo de código abierto en el conjunto de pruebas Konfuzio, y aproximadamente el doble de rápido. Funciona bajo una licencia que permite el uso comercial sin umbrales, en una sola máquina, y ningún documento tiene que salir de la empresa. En este conjunto de pruebas, es el primer modelo que combina ambas cosas: proveedor y datos de entrenamiento en el espacio jurídico europeo y resultados al nivel del mejor modelo de código abierto.
Las limitaciones son las mismas que en todos los modelos: tablas largas que hay que leer por secciones y un conjunto de herramientas que aún va por detrás del modelo. Quien quiera conocer los valores para sus propios documentos, necesita su propio conjunto de pruebas. Con 17 documentos y valores teóricos comprobados, se pudo medir de forma fiable la precisión y la velocidad en este caso.
En resumen, cabe señalar que, a pesar de las limitaciones de la prueba, los primeros indicios son muy positivos. Kolibri-1, de Aleph Alpha, es una señal clara de la presencia europea en el mercado de la inteligencia artificial y puede constituir una alternativa real, especialmente para aquellas empresas en las que el cumplimiento normativo y la protección de datos desempeñan un papel fundamental, ya que, a diferencia de la competencia internacional, el proveedor está siempre sujeto a la legislación europea.
AEl origen de los datos de entrenamiento está documentado. Según Comunicado de prensa del 5 de octubre de 2026 Todos los datos se han cotejado con una lista de bloqueo que contiene más de 4,5 millones de URL. Esta lista se basa, entre otras cosas, en la «Piracy Watch List» de la Comisión Europea. Según el mapa conceptual, Aleph Alpha es además signatario del Código de buenas prácticas de la GPAI de la UE.
Kolibiri-1 también se puede integrar en las soluciones de Konfuzio. Por lo tanto, no dude en ponerse en contacto con nosotros si tiene interés o alguna pregunta al respecto.

 ES
 DE
 EN
 FR