
Antes de que una IA pueda comprender un documento, es necesario reconocer el texto que contiene. De ello se encarga el reconocimiento óptico de caracteres, conocido como OCR (Optical Character Recognition). Este proceso se lleva a cabo bien a través de un servicio en la nube, bien en el propio hardware.
La elección parece una cuestión de protección de datos. Pero también es una cuestión de tiempo de espera. Hemos comparado ambas opciones utilizando los mismos documentos auténticos. En este artículo se muestran las cifras, los motivos y nuestra decisión.
La estructura: un servidor en Alemania, un servicio en la UE
«On-premise» significa que el reconocimiento de texto se ejecuta en nuestro propio hardware, en lugar de en el del proveedor de servicios en la nube. Hemos realizado las mediciones en nuestro propio servidor, ubicado en un centro de datos en Alemania. En el centro de datos de un cliente funciona exactamente igual.
El servidor es una única máquina con 8 núcleos de procesador y unos 65 GB de memoria RAM. En él se ejecuta el sistema de detección como un contenedor, es decir, como un paquete de software independiente. El mismo proveedor también ofrece este sistema de reconocimiento como servicio en la nube. Los documentos y los resultados solo se almacenan en la memoria RAM del servidor; no se guarda nada en el disco duro.
A modo de comparación, se utilizó el servicio en la nube del mismo proveedor, ubicado en un centro de datos de la UE. Se accede a él a través de una API de OCR. Las mediciones se realizaron con documentos comerciales disponibles públicamente, entre los que se incluyen fichas técnicas, informes anuales, informes de fondos y fichas de datos de seguridad.
Todos los tiempos se refieren a un reconocimiento OCR completo, que también incluye el diseño del documento, las tablas, las casillas de selección y la ubicación de cada texto; es decir, en realidad va más allá del mero reconocimiento de texto. El tiempo se midió desde el envío hasta el resultado final, incluida la subida del archivo.
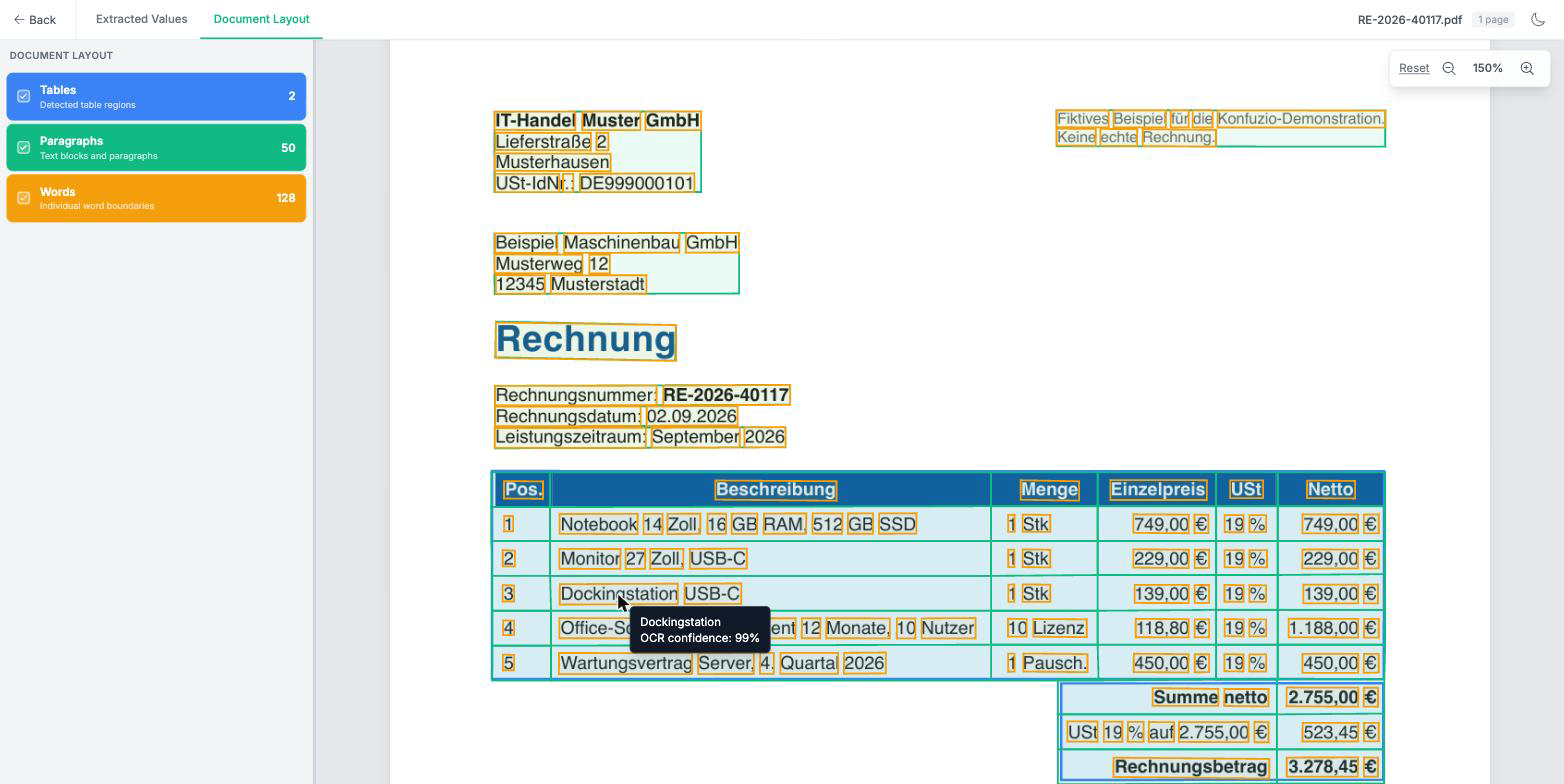
Así es como se ve el resultado en la vista „Document Layout“ de nuestro visor de documentos: las tablas, los párrafos y las palabras individuales aparecen resaltadas. Al pasar el ratón por encima de una palabra, aparece su índice de legibilidad; en este caso, el 99 % para „Dockingstation“.
Los valores medidos
Realizamos las mediciones el 29 de octubre y el 2 de noviembre de 2026, utilizando los mismos archivos en ambos casos. Las cifras son medianas, es decir, valores medios: la mitad de los documentos se procesaron más rápido y la otra mitad, más lento. En el caso de los documentos largos, se trata de una sola ejecución en cada caso.
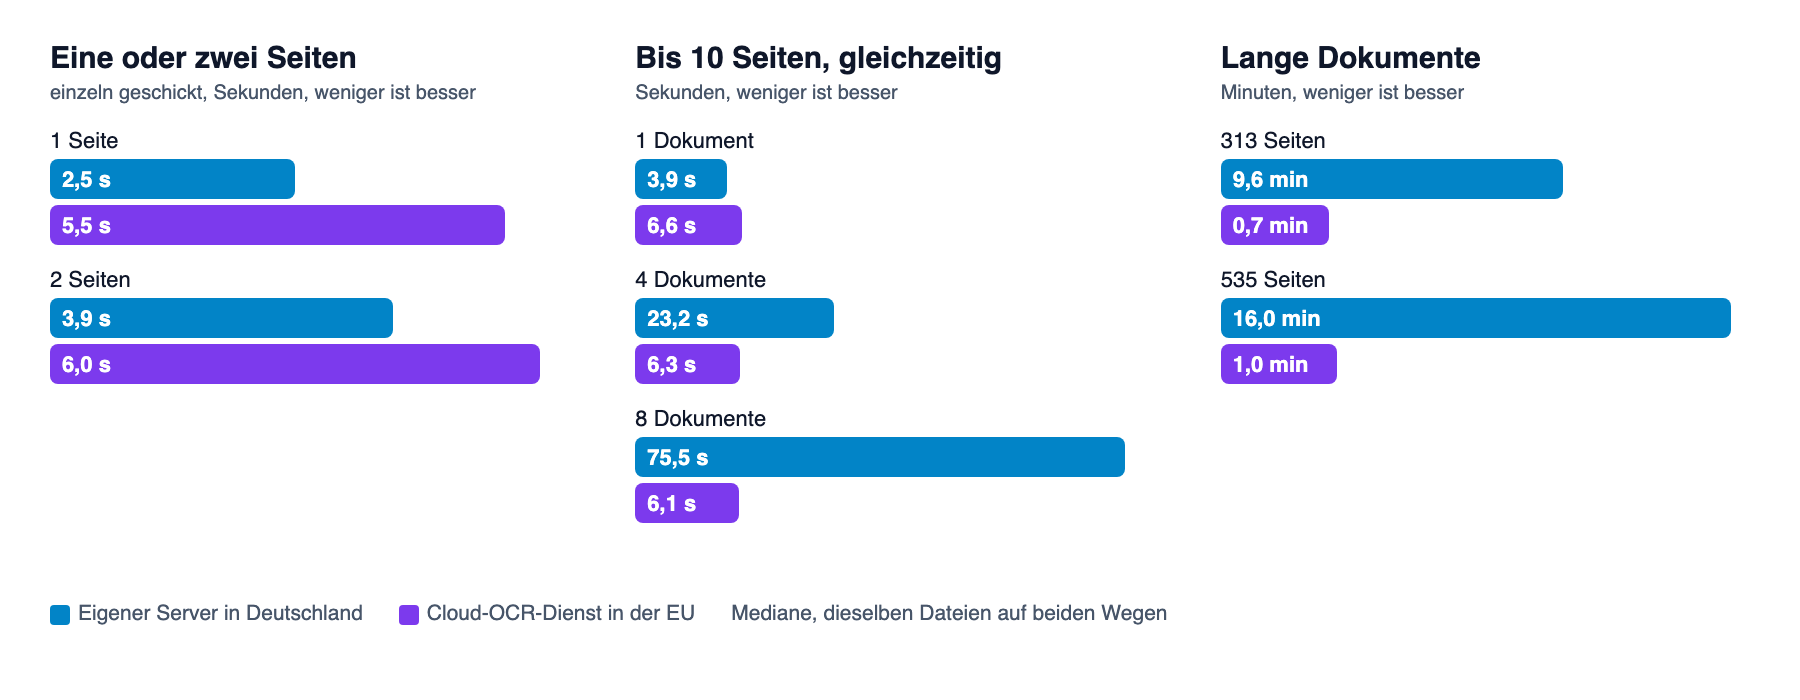
Documentos breves, uno tras otro. Se enviaron alternativamente, en tres rondas, diez documentos de una sola página y nueve de dos páginas por ambas vías. Una página se cargaba en el servidor propio en 2,5 segundos y en la nube en 5,5. En el caso de dos páginas, los tiempos fueron de 3,9 y 6,0 segundos. En los 57 casos, el servidor propio fue más rápido.
Varios documentos a la vez. En el caso de documentos de hasta diez páginas, enviados de forma individual, el servidor propio tardó 3,9 segundos y la nube, 6,6. Si se enviaban cuatro a la vez, el servidor propio tardaba 23 segundos y la nube, 6,3. Con ocho a la vez, el tiempo fue de 75,5 frente a 6,1 segundos. La nube se mantiene en unos seis segundos, independientemente del número de documentos que se reciban.
Documentos largos. Aquí es donde la diferencia es mayor. Un documento de 313 páginas tardó 9,6 minutos en el servidor propio y 43 segundos en la nube. En el caso de 535 páginas, el tiempo fue de 16,0 minutos frente a 59 segundos.
Por qué los documentos largos tardan tanto en cargarse en un servidor
Un servidor individual tiene una potencia de cálculo fija. Nuestro servidor procesa, con la detección de maquetación, entre 36 y 48 páginas por minuto; la media medida a lo largo de toda una noche fue de 37. Para aumentar esta cifra, solo es necesario disponer de más máquinas.
Según hemos observado, el servicio en la nube distribuye el trabajo entre muchos equipos. Así, se obtuvieron 535 páginas en 59 segundos. En el caso de un único documento breve, esta distribución no resulta de gran ayuda. Lo que importa es la rapidez con la que se inicia una tarea, y nuestro propio servidor fue más rápido en nuestra prueba.
Además, en el servidor propio hay una cola. Este procesa los trabajos por orden. Si había documentos largos al principio de la cola, un documento de dos páginas tardaba casi diez minutos. Se leía rápidamente, pero no le llegaba el turno.
Se nos interrumpió una tarea que llevaba ejecutándose más de una hora aproximadamente. Por eso, quien procese documentos largos en su propio equipo, debe dividirlos previamente en secciones.
OCR local: ventajas y desventajas
Hay tres razones a favor del hardware propio:
- Lugar de tratamiento: Los documentos no salen del centro de datos en el que se encuentra el servidor.
- Tiempo de respuesta breve: Una página se cargaba en 2,5 segundos, mientras que en la nube tardaba 5,5.
- Costes fijos de hardware: Una máquina tiene un coste fijo al mes, independientemente de su nivel de utilización.
Hay cuatro argumentos en contra:
- Potencia limitada: Un servidor lee unas 40 páginas por minuto gracias al reconocimiento de maquetación.
- Cola: Un documento largo retrasa a los cortos si nadie controla el orden.
- Funcionamiento: Las actualizaciones, los reinicios y la supervisión son responsabilidad del operador. Si un servidor concreto deja de funcionar, ningún otro toma el relevo.
- No hay ahorro por página: Con nuestro proveedor, la página cuesta lo mismo en nuestro propio hardware que en la nube. El hardware supone un coste adicional.
API de OCR en la nube: ventajas y desventajas
Hay tres razones a favor del servicio en la nube:
- Velocidad bajo carga: Incluso con ocho documentos a la vez, el tiempo de respuesta se mantuvo en unos seis segundos. Se leyeron 535 páginas en 59 segundos, en lugar de en 16,0 minutos.
- Fuera de servicio: Sin servidor propio, sin actualizaciones, sin supervisión.
- Pago por uso: La facturación se realiza por página. No es necesario disponer de una máquina para los picos de carga ocasionales, ya que, de lo contrario, permanecería sin utilizar.
Hay tres razones en contra:
- Los documentos salen de la empresa: El proveedor las trata en su centro de datos. Para ello es necesario un contrato de encargado del tratamiento, de conformidad con el artículo 28 del RGPD.
- Acceso desde el extranjero: Para los proveedores sujetos a la legislación estadounidense, se aplica lo siguiente: Artículo 2713 del Código de los Estados Unidos, título 18. Por orden judicial, deben custodiar o facilitar datos, „independientemente de si dicha comunicación, registro u otra información se encuentra dentro o fuera de Estados Unidos“. Es decir: da igual si los datos se encuentran en EE. UU. o no. El mero hecho de estar ubicados en la UE no protege frente a este acceso.
- Límites a la hora de subir archivos: Al subir dos archivos de 7 y 15 MB, la subida de una sección se interrumpió por un tiempo de espera agotado. El segundo intento tuvo éxito.
El artículo describe la ponderación general En las instalaciones o en la nube. El coste del reconocimiento de texto por página se indica en Resumen de los costes del OCR.
La factura para documentos largos
Se podría simplemente multiplicar el número de servidores propios. Para distribuir documentos largos, como los de la nube, entre varias máquinas, necesitaríamos, según una estimación aproximada, diez máquinas de este tipo. Eso supondría unos 1.000 euros al mes solo para el reconocimiento de texto.
Sin embargo, los documentos largos de cientos de páginas son poco frecuentes en nuestra empresa. Las máquinas estarían paradas la mayor parte del tiempo. Por eso hemos decidido no ampliar la capacidad.
En su lugar, ofrecemos ambas opciones. Quienes solo permitan el tratamiento de datos en Alemania, dispondrán de nuestro servidor en Alemania. En ese caso, un documento de unas 300 páginas tardará 9,6 minutos en procesarse, en lugar de 43 segundos. Quienes permitan el tratamiento de datos en la UE, dispondrán del servicio en la nube. Para más información sobre el funcionamiento en hardware propio, consulta IA local.
¿Cuál es su posición?
- ¿Recibe sus documentos de forma dispersa a lo largo del día o todos juntos por la mañana?
- ¿Cuál es el documento más largo que tiene: diez páginas o 500?
- ¿Sus contratos permiten el tratamiento de datos en la UE o solo en Alemania?
- ¿Hay que esperar el resultado, o el proceso se ejecuta en segundo plano?
- ¿Quién se encarga de las actualizaciones y las interrupciones del servicio si el servidor está en sus instalaciones?
Conclusión
Para documentos cortos individuales, un servidor OCR propio es más rápido: 2,5 segundos en lugar de 5,5 por página, en las 57 comparativas. En cuanto llegan muchos documentos a la vez o un documento tiene cientos de páginas, la nube toma la delantera. 535 páginas tardaron 16,0 minutos en nuestro servidor, mientras que en la nube tardaron 59 segundos.
Por lo tanto, la decisión no parte de la tecnología, sino del contrato. ¿Dónde se pueden procesar sus documentos? De ahí depende el procedimiento a seguir, y así se pueden planificar los plazos. Si desea probar sus propios documentos en ambas modalidades, póngase en contacto con nosotros.

 ES
 DE
 EN
 FR