
Un problema importante en el aprendizaje automático (AM) que suele surgir cuando se quiere mejorar el rendimiento es el coste de configuración de la obtención de datos. Generar datos de alta calidad para aumentar la precisión predictiva suele ser difícil, caro o simplemente imposible. Además, a diferencia del propio modelo de IA, los datos suelen considerarse menos importantes. Esto se debe a que los ingenieros de ML tienden a cambiar el código de un modelo en lugar de limpiar el conjunto de datos. Pero en las aplicaciones de IA en particular, es importante examinar los datos porque el sistema se basa tanto en el código como en los datos, a diferencia del software tradicional que se basa sólo en el código. Aunque se suele suponer que el 80 % de las actividades en el aprendizaje automático están relacionadas con la limpieza de datos, garantizar la calidad de los datos (centrado en los datos) no se considera tan importante como trabajar en el modelo (centrado en el modelo). [1]
Pero, ¿por qué nadie utiliza un enfoque centrado en los datos?
Aquí intervienen varios factores. Por un lado, un enfoque centrado en los datos se considera una tarea larga y tediosa; por otro, también es difícil definir qué constituye exactamente un buen conjunto de datos. Sin embargo, la necesidad de trabajar con un buen conjunto de datos será aún más importante en el futuro, ya que la cantidad de datos sin etiquetar aumenta en general debido a las formas más baratas de recopilar y almacenar datos. Para crear buenos modelos, se necesitan buenos datos, y eso tiene un precio. "(...) es difícil y caro obtener datos anotados, sobre todo en ámbitos especializados en los que sólo los expertos, cuyo tiempo es escaso y valioso, pueden proporcionar etiquetas fiables". [2] En respuesta a esta situación, los investigadores han empezado a concienciarse sobre la necesidad de salvar la distancia entre la adquisición de datos y la construcción de modelos. Aquí es precisamente donde entra en juego la disciplina del Aprendizaje Activo.
¿Cómo ayuda el Aprendizaje Activo a obtener mejores datos?
El aprendizaje activo integra el conocimiento humano en el aprendizaje automático, lo que reduce significativamente los requisitos de datos y aumenta las predicciones de la IA. "Su objetivo es seleccionar los ejemplos más útiles del conjunto de datos sin etiquetar y pasárselos al oráculo (por ejemplo, el anotador humano) para que los etiquete, reduciendo al máximo el coste del etiquetado sin comprometer el rendimiento." [3] El aprendizaje activo es especialmente útil cuando la cantidad de datos es demasiado grande para etiquetar o cuando es necesario establecer prioridades para una forma inteligente de etiquetado. El Procesamiento del Lenguaje Natural (PLN) es una de las áreas más populares en las que se utiliza el Aprendizaje Activo. Principalmente porque las aplicaciones de PNL requieren una gran cantidad de datos etiquetados, el coste de etiquetarlos es muy elevado. El uso del aprendizaje activo en PNL reduce la cantidad de datos que deben ser etiquetados con precisión por un experto en el proceso de formación de un modelo. En cambio, el modelo etiqueta los datos por sí solo y pide información cuando no está seguro de si es la etiqueta correcta.
Existen tres tipos diferentes de Aprendizaje Activo mencionados en distintos trabajos de investigación. El método más común es el aprendizaje basado en conjuntos de datos (Pool-Based Learning), que toma los casos más informativos, a los que se asigna una puntuación, de todo el conjunto de datos y solicita etiquetas al ser humano. El muestreo selectivo basado en flujos evalúa individualmente la información de cada punto de datos sin etiquetar y decide por sí mismo si consulta al ser humano o le asigna una etiqueta. Membership Query Synthesis es un método en el que el modelo genera su propia instancia a partir de una distribución natural subyacente. Pero cualquier tipo de priorización de puntos de datos requiere algunos pasos generales para llevar a cabo el Aprendizaje Activo en un conjunto de datos sin etiquetar. En primer lugar, hay que etiquetar manualmente un subconjunto muy pequeño de datos, sobre el que luego se entrena el modelo. A continuación, el modelo predice la clase de los puntos de datos no etiquetados, elige una puntuación basada en la predicción del modelo y asigna a los humanos los puntos de datos que deben etiquetarse. El enfoque del proceso de formación se denomina aprendizaje semisupervisado, lo que significa que sólo hay una pequeña cantidad de datos etiquetados pero una gran cantidad de datos sin etiquetar. Tras recibir los comentarios humanos, el modelo puede entrenarse con el conjunto de datos etiquetados aumentados, lo que mejora el rendimiento del modelo cada vez que pasa por el ciclo.

Cómo integramos el aprendizaje activo para lograr un mejor rendimiento predictivo
En la siguiente parte, explicamos cómo implementamos el enfoque de Aprendizaje Activo en la plataforma de IA Konfuzio. Utilizamos el enfoque de muestreo selectivo basado en flujos, pero lo ampliamos para nuestra aplicación, en la que necesitamos más bien un enfoque centrado en los datos que sea adecuado para un comportamiento de aprendizaje continuo. Esto es necesario porque nuestro objetivo no es entrenar un gran conjunto de datos una vez y utilizarlo a continuación, sino entrenar el modelo con un conjunto de datos pequeño y aumentar continuamente el rendimiento predictivo mediante el reentrenamiento. Uno de los métodos a los que se puede hacer referencia es el aprendizaje incremental, cuyo objetivo es aumentar el conocimiento del modelo a lo largo del tiempo a medida que se dispone de nuevos datos de entrenamiento [4]. De este modo, el enfoque de aprendizaje activo se extiende a lo largo de un periodo de tiempo más largo y tiene lugar de forma regular. Entonces, ¿cuáles son los pasos para mejorar nuestros resultados en un nuevo proyecto utilizando el Aprendizaje Activo? A continuación se ofrece una representación visual del proceso y una descripción de cada paso.

El aprendizaje activo tiene lugar en la etapa de "retroalimentación", en la que es necesaria la interacción con el usuario para mejorar las predicciones del modelo. Aquí podemos hablar de la aplicación "human-in-the-loop", que combina nuestro modelo de aprendizaje automático con la interacción humana. Esto permite reentrenar nuestro modelo con frecuencia y rapidez, ya que nos beneficiamos de una retroalimentación continua al hacer que la IA se dirija a los humanos. Este enfoque mejora de forma regular y continua el rendimiento predictivo al tiempo que adopta una visión centrada en los datos.
¿Cómo funciona en la práctica el aprendizaje activo?

El aprendizaje activo en la práctica con el ejemplo de los documentos
- Seleccionar problema
El usuario selecciona un caso de uso para el tratamiento de documentos por la IA. Una definición clara de las etiquetas que deben extraerse es el punto de partida del proceso de aprendizaje activo de la IA.

- Recopilar datos
El usuario carga archivos en la plataforma Konfuzio compuestos por documentos para la formación y validación y documentos para las pruebas (por ejemplo, en una proporción de 70/30). Ahora, los datos de formación deben ser etiquetados manualmente por el usuario o puede utilizarse un modelo de IA de código abierto para preetiquetar los datos.
- Comprobar datos
Se comprueba la coherencia de los datos de formación etiquetados y, si es necesario, se corrigen o amplían. En otro artículo técnico mostramos cómo controlamos la calidad de nuestros datos de formación resumiéndolos de forma automatizada. Por el artículo.
- Entrenar IA
A continuación, se inicia la formación automatizada con datos de formación etiquetados. Se selecciona la mejor arquitectura de modelo para el caso de uso correspondiente.
- Prueba AI
Tras el entrenamiento, se realiza una prueba automatizada de la IA entrenada en el conjunto de datos de prueba cargados.
- Informe
El informe muestra si el "nuevo" modelo de IA es mejor que el anterior cuando se incluye el conjunto de datos de prueba. Si no, se utiliza el modelo anterior para el siguiente paso.
- IA desplegada
Si el "nuevo" modelo es mejor que el anterior, Konfuzio actualiza la API con la última IA entrenada.
- Mundo real
Ahora entran en juego nuevos datos/documentos del "mundo real", que se procesan con la IA utilizada. Se calculan las predicciones de las nuevas etiquetas. Los documentos pueden acceder a la IA desplegada directamente a través de API o Python SDK.
- Comentarios
Todos los datos reconocidos de un documento se muestran al usuario marcando las etiquetas en la Smartview. Esta interfaz permite al usuario dar su opinión sobre las predicciones mostrándolas visualmente en el documento correspondiente. Se puede confirmar la corrección haciendo clic en una marca verde, o descartar una etiqueta incorrecta haciendo clic en una X roja. Además, el usuario puede añadir etiquetas que se hayan omitido por error. Es preferible que los documentos que no hayan podido reconocerse con las reglas generadas automáticamente reciban una respuesta humana (véase el paso 3).
- Recopilar datos
Los comentarios del usuario se vuelven a introducir en el conjunto de datos en el paso repetido de "recopilación de datos". Una etiqueta aceptada sólo confirma la corrección, la respuesta de rechazo o la adición de una etiqueta aumenta la precisión de la predicción al reentrenar el modelo. Los datos del "mundo real" de antes se introducen ahora en el bucle para la formación.




Conclusión
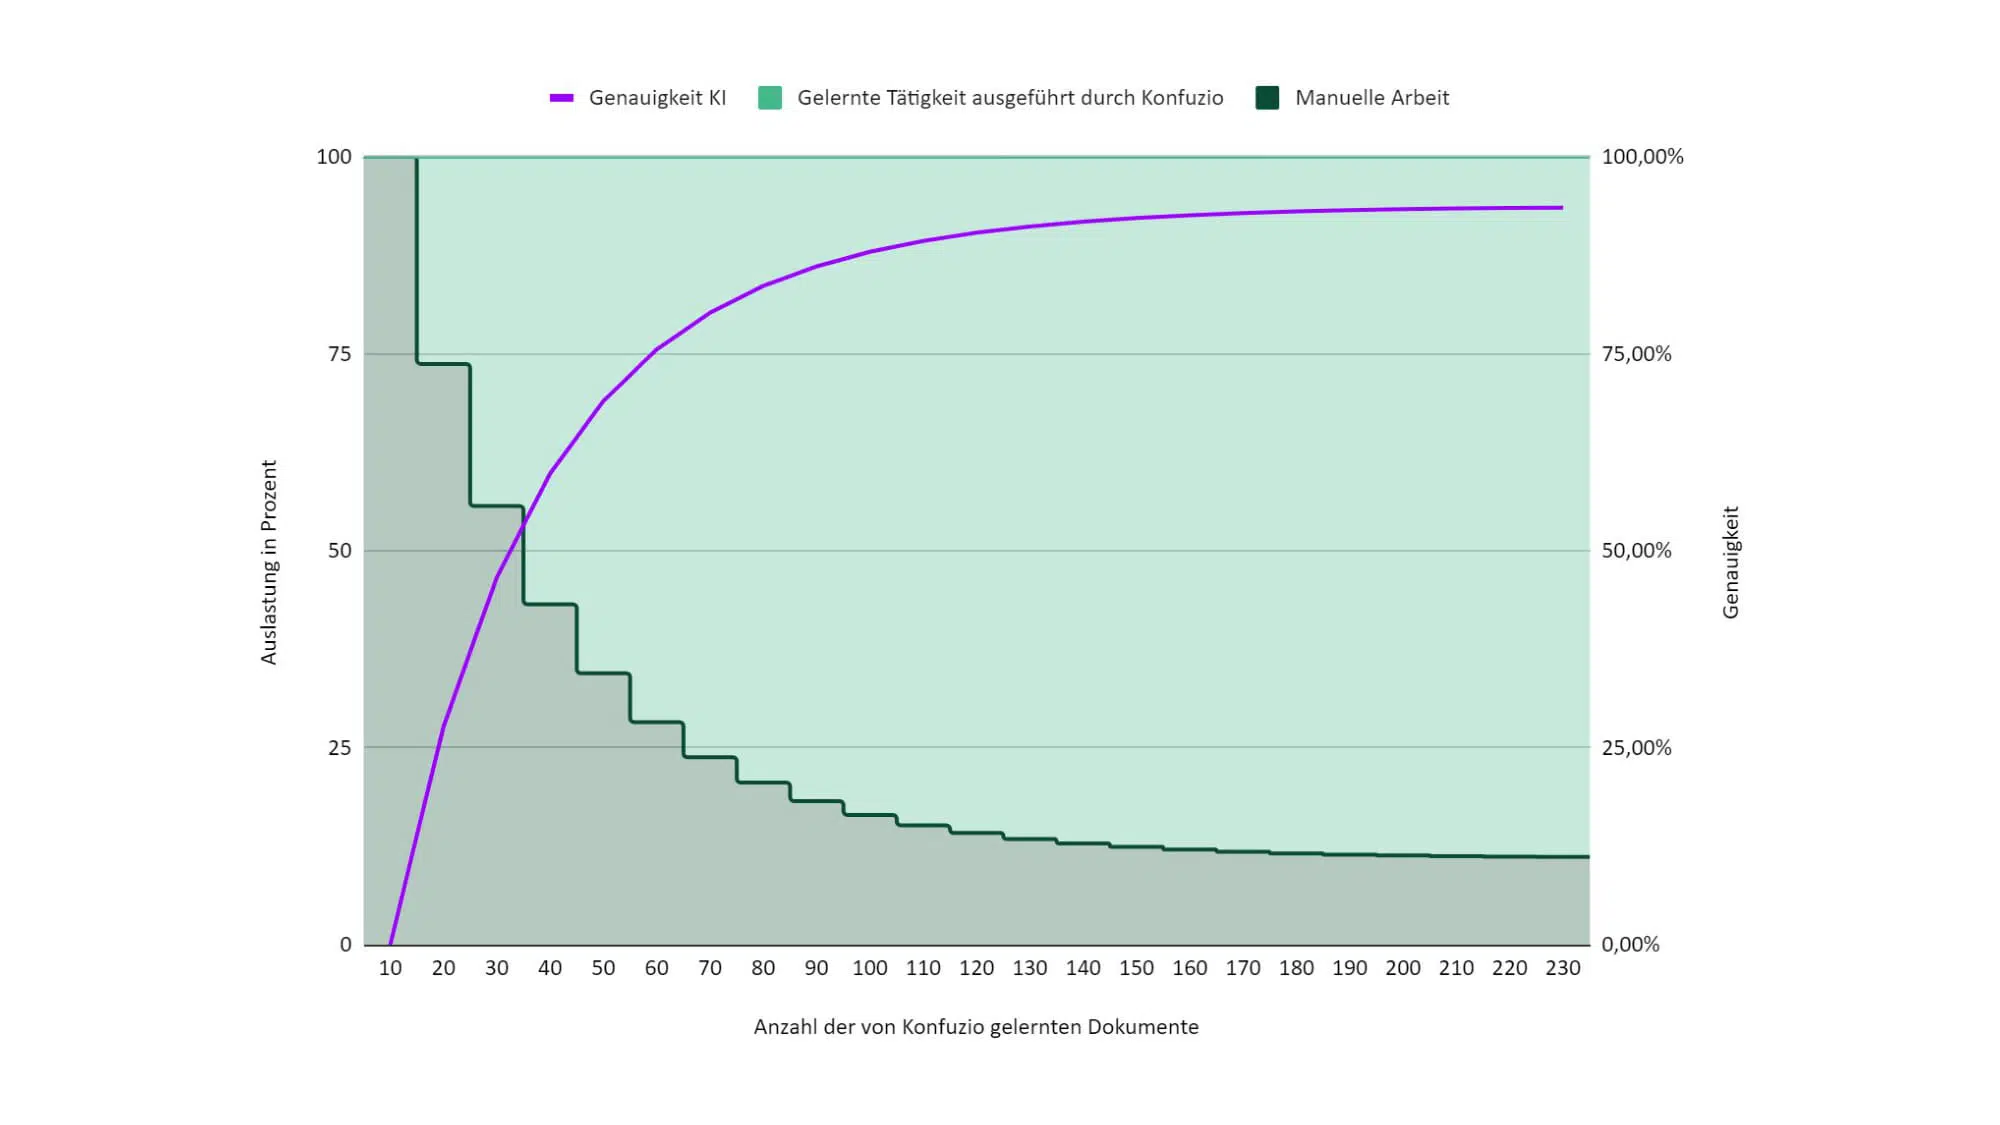
El aprendizaje activo ayuda a mejorar continuamente las predicciones de los nuevos modelos de IA y aprendizaje automático. Las ventajas de incorporar un enfoque de aprendizaje activo son la reducción de costes, el uso de pequeñas cantidades de datos para la primera versión de la IA, el aumento de la fiabilidad y una solidez cada vez mayor mediante pruebas continuas de la precisión de la IA. El cambio hacia un desarrollo centrado en los datos hace que la IA sea accesible a más equipos de usuarios y a muchos más casos de uso. Especialmente para los modelos con conjuntos de datos más pequeños, la calidad de los datos mejora significativamente el rendimiento de la IA.
Para los científicos de datos, también ofrecemos un SDK de Python además de la interfaz web.

Human-in-the-loop como cuaderno Colab
Fuentes:
Foto de Andrea Piacquadio de Pexels

 ES
 DE
 EN
 FR