
La collecte et l'analyse des données ont fait des progrès considérables ces dernières années, et la génération augmentée de récupération (RAG) ne fait pas exception. Les développements technologiques futurs amélioreront encore les modèles RAG et élargiront leurs domaines d'application. En particulier, le développement d'algorithmes de traitement du langage naturel augmentera l'efficacité et la précision de ces systèmes. On s'attend à l'avenir à des algorithmes plus avancés, qui non seulement optimiseront la récupération des données, mais amélioreront également la vitesse de traitement et la capacité d'adaptation aux sources d'information dynamiques. Ces progrès pourraient avoir des répercussions importantes sur la manière dont les informations sont récupérées et générées, en particulier dans un environnement numérique en constante évolution.
Que signifie RAG ?
La génération augmentée de recherche (RAG) est une méthode qui combine des mécanismes de recherche avec des modèles génératifs afin d'améliorer la qualité des réponses. L'utilisation de la RAG permet aux systèmes non seulement d'accéder à des connaissances déjà existantes, mais aussi de récupérer des informations pertinentes dans des documents ou des sources de données volumineux. Cette combinaison permet de fournir des réponses plus précises et contextuelles à des questions complexes, plutôt que de se fier exclusivement aux connaissances stockées dans le modèle.
Historiquement, la RAG s'est développée en réponse aux limites des approches traditionnelles du traitement du langage naturel (NLP). Alors que les modèles précédents étaient généralement basés soit sur des algorithmes à base de règles, soit sur des ensembles de données statiques, la RAG offre la flexibilité d'accéder de manière dynamique aux informations actuelles. Cette évolution reflète le besoin d'agir plus efficacement dans un paysage informationnel en rapide évolution et de générer des réponses précises à partir de données volumineuses et souvent non structurées.
L'introduction des techniques RAG a donc non seulement permis d'améliorer considérablement les performances dans des applications spécifiques, mais a également créé de nouvelles opportunités pour le développement de systèmes interactifs et intelligents. Les modèles RAG actuels se caractérisent par une capacité accrue à fournir des réponses contextuelles, en combinant des stratégies d'extraction optimales tout en exploitant les forces des modèles génératifs. Ces avancées ouvrent la voie à de nombreux champs d'application, allant du service client automatisé à l'aide aux chercheurs pour la recherche d'informations.
Retrieval Augmented Generation - en abrégé RAG - est une méthode utilisée en l'intelligence artificielle (KI) et la traitement naturel du langage, qui vise à améliorer les performances des LLM en intégrant des systèmes d'extraction externes. Cette technique permet d'extraire des données de sources externes, telles que des corpus organisationnels ou des bases de données documentaires, et sert à enrichir les données utilisées pour conditionner le modèle linguistique (LLM). Prompts.
Comment RAG utilise-t-il les LLM ?
Retrieval Augmented Generation exploite la puissance de grands modèles linguistiques, appelés Large Language Models comme GPT-4, en combinaison avec des mécanismes externes d'extraction ou de recherche. Au lieu de s'appuyer uniquement sur les connaissances internes du modèle, RAG interroge un ensemble de données externes, typiquement un corpus de documents, pour obtenir des informations pertinentes. Ces données récupérées sont ensuite utilisées pour générer une réponse contextuelle.
Comparaison entre le RAG et les méthodes PNL traditionnelles
L'efficacité de la RAG par rapport aux méthodes PNL traditionnelles est significative. Alors que les systèmes conventionnels sont souvent basés sur des modèles pré-entrainés, limités à des ensembles de données statiques, la RAG permet d'accéder à des informations actualisées et variées. Un système RAG peut interroger des données pertinentes et les traiter en temps réel, ce qui rend les réponses aux demandes des utilisateurs plus précises et plus pertinentes.
La dynamique de RAG augmente la pertinence des réponses en donnant accès à des sources d'information actualisées.
L'intégration de mécanismes d'extraction maximise la pertinence des réponses en intégrant des contenus actuels provenant de sources de données étendues. Ceci est particulièrement avantageux dans des domaines en évolution rapide comme la santé, le droit ou le journalisme, où des informations actualisées sont essentielles pour prendre des décisions et des analyses fondées.
Intégration RAG avec d'autres systèmes d'IA
Un aspect important des développements futurs de RAG est la possibilité d'intégrer cette technologie avec d'autres systèmes d'IA. La synergie entre RAG et des systèmes existants tels que l'apprentissage automatique, le traitement d'images ou les modèles génératifs ouvre de nouvelles perspectives d'applications dans différents secteurs. Grâce à la multimodalité de ces approches, les modèles RAG pourraient être en mesure de traiter simultanément non seulement du texte, mais aussi des images et d'autres formats de données. Cette intégration pourrait être particulièrement avantageuse dans des domaines tels que la santé, où les données visuelles et les textes doivent être coordonnés pour soutenir des analyses et des décisions globales.
Applications RAG et éthique de l'IA
Avec la mise en œuvre croissante de systèmes RAG dans différents secteurs, des considérations éthiques doivent également être prises en compte lors de leur développement et de leur utilisation. La responsabilité dans le traitement des données sensibles est d'une importance capitale. Il convient de s'assurer que les sources d'information utilisées ne favorisent pas un contenu discriminatoire ou injustifié. En outre, le risque de préjugés dans les algorithmes doit également être minimisé afin d'obtenir des résultats justes et équitables. Les normes et directives éthiques doivent être intégrées dans le processus de développement afin de renforcer la confiance des utilisateurs dans les technologies RAG.
Mise en œuvre du RAG
La réussite de la mise en œuvre de RAG nécessite le respect de bonnes pratiques basées sur des années d'expérience dans le développement et l'utilisation de systèmes d'information. Une approche itérative du développement est essentielle pour permettre des améliorations et des ajustements continus. Un retour d'information régulier de la part des utilisateurs peut aider à identifier et à corriger les éventuelles faiblesses à un stade précoce. La collaboration entre différentes disciplines, telles que les scientifiques des données, les ingénieurs et les professionnels, favorise les solutions innovantes et améliore la qualité du produit final. En outre, une documentation complète des processus et des algorithmes devrait être établie afin d'assurer la durabilité et la maintenance à long terme.
Indicateurs de performance
Lors de la mise en œuvre de systèmes RAG, il est important de définir des indicateurs de performance appropriés qui permettent d'évaluer l'efficacité et l'efficience du système. Ces indicateurs de performance doivent inclure non seulement la précision des réponses, mais aussi les temps de latence et la flexibilité du système face aux différentes requêtes des utilisateurs. En mesurant ces indicateurs en continu, les entreprises peuvent prendre des mesures ciblées pour optimiser et améliorer les performances de leurs systèmes RAG. Des indicateurs de performance efficaces aident non seulement à identifier les possibilités d'amélioration, mais favorisent également la confiance dans la capacité de déploiement de la technologie.
Ces paragraphes distincts sur les avancées technologiques, l'intégration avec d'autres systèmes d'IA, les considérations éthiques, les bonnes pratiques et les indicateurs de performance peuvent être insérés de manière transparente dans votre article existant.
1. résumé
La génération augmentée de recherche (RAG) s'est imposée comme une technologie qui modifie considérablement la manière dont les informations sont traitées et mises à disposition. Cet aperçu présente les cas d'application les plus significatifs de la RAG, qui sont d'une grande utilité dans différents secteurs et domaines.
L'une des principales applications de la RAG est le résumé de contenu. Les modèles RAG modernes ont la capacité d'analyser de grandes quantités de texte et d'en extraire précisément les informations les plus importantes. À une époque où l'information est de plus en plus abondante et où les utilisateurs souhaitent accéder rapidement à des contenus pertinents, RAG offre une solution efficace.
L'analyse intelligente permet de créer des résumés clairs et informatifs qui mettent en évidence les messages et les tendances essentiels. Cette capacité est particulièrement précieuse dans des domaines tels que les services d'information, où les journalistes doivent traiter quotidiennement de grandes quantités d'informations, et les publications scientifiques, où les chercheurs passent en revue une multitude d'études et de données. L'utilisation de RAG leur permet de saisir plus rapidement les informations dont ils ont besoin et donc de travailler plus efficacement.
2. génération de questions
Un autre cas d'utilisation remarquable de RAG est la génération de questions . Cette technologie permet aux modèles RAG de formuler des questions pertinentes et contextuelles qui sont importantes dans différents contextes. Cette capacité est particulièrement utile dans le secteur de l'éducation. Les établissements d'enseignement peuvent utiliser RAG pour créer des questions d'apprentissage et des examens personnalisés, adaptés aux besoins spécifiques des apprenants.
En outre, les chercheurs bénéficient également de la génération de questions par RAG, car elle leur permet de développer des questions de recherche pertinentes et innovantes. Ces questions peuvent servir de cadre à de nouvelles connaissances et découvertes, en incitant les chercheurs à se plonger plus profondément dans le sujet et à développer des capacités de réflexion critique. L'intégration active de questions dans les processus d'apprentissage et de recherche contribue à accroître l'engagement et la curiosité.
3. systèmes de questions-réponses
Un scénario d'application central de RAG se présente dans le domaine des systèmes de questions-réponses . Dans ce domaine, la technologie permet aux utilisateurs d'accéder de manière ciblée et rapide à des informations précises issues de vastes bases de données. RAG combine des techniques d'extraction avancées avec des modèles génératifs pour extraire les données pertinentes et les transformer en réponses compréhensibles.
Grâce à cette combinaison, les entreprises peuvent développer des chatbots intelligents qui sont utilisés dans le service clientèle pour répondre efficacement aux demandes et améliorer l'expérience client. En outre, les systèmes RAG sont également utilisés dans les systèmes d'information d'entreprise, qui aident les collaborateurs à trouver rapidement les données dont ils ont besoin, sans avoir à les chercher longtemps. Cette efficacité dans la recherche d'informations est particulièrement précieuse dans les environnements critiques pour l'entreprise.
4. applications pratiques par secteur et par industrie
RAG ne se limite pas à des analyses théoriques, mais a également trouvé des applications pratiques significatives dans différents secteurs. Dans le secteur de la santé, RAG permet aux médecins d'analyser plus rapidement les données pertinentes des patients et d'accéder aux résultats actuels de la recherche. Cela favorise une prise de décision éclairée et encourage les approches de traitement personnalisées, ce qui améliore en fin de compte la qualité des soins aux patients.
Impact des LLM sur le marché du travail
L'introduction des Large Language Models (LLMs) a des répercussions importantes sur le marché du travail. Les systèmes basés sur l'IA et les LMR modifient les besoins en main-d'œuvre qualifiée dans de nombreux secteurs. L'automatisation par les LLM peut accroître l'efficacité, mais aussi mettre en péril les professions existantes. La nécessité de développer de nouvelles compétences dans l'utilisation des technologies d'IA devient de plus en plus indispensable pour les travailleurs.
Intégration de l'IA dans les systèmes éducatifs
L'intégration des technologies d'IA, dont la RAG, dans les systèmes éducatifs promet un changement profond dans la manière dont les connaissances sont transmises et apprises. Grâce à la RAG, les enseignants et les apprenants ont accès à des contenus d'apprentissage sur mesure, adaptés aux besoins individuels.
La possibilité de fournir des informations contextualisées à tout moment révolutionne les méthodes d'apprentissage et permet de personnaliser l'expérience éducative. Ces approches favorisent l'apprentissage actif et contribuent à ce que les élèves et les étudiants ne se contentent pas de consommer des informations, mais les traitent de manière critique. L'introduction des RAG dans les écoles et les universités pourrait modifier considérablement l'enseignement dans les années à venir.
L'intégration des RAG dans les systèmes éducatifs pourrait révolutionner la manière dont les connaissances sont transmises.
RAG dans l'assurance et RAG dans la banque Secteur bancaire
La génération augmentée de recherche (RAG) a le potentiel de transformer fondamentalement les secteurs de l'assurance et de la banque. La capacité de RAG à extraire des données pertinentes en temps réel et à fournir des réponses contextuellement précises permet aux compagnies d'assurance de mettre en œuvre des services clients extrêmement efficaces. Les agents d'assurance peuvent utiliser RAG pour répondre rapidement à des questions spécifiques sur les polices, les options de couverture et les rapports de sinistre. Cela améliore non seulement la satisfaction des clients, mais augmente aussi considérablement l'efficacité du traitement des demandes et des sinistres.
Dans le secteur bancaire, RAG présente également des applications prometteuses. Les banques peuvent utiliser RAG pour offrir à leurs clients des conseils personnalisés basés sur leurs données financières et leurs besoins spécifiques. L'intégration de RAG dans les applications bancaires mobiles permet aux utilisateurs d'obtenir des réponses immédiates à des questions complexes, par exemple sur l'octroi d'un crédit ou l'investissement d'un capital. Cette approche personnalisée permet d'améliorer la fidélisation des clients et permet aux banques de promouvoir des décisions financières éclairées, ce qui se traduit au final par des taux de satisfaction plus élevés.
Malgré les nombreux avantages qu'offre la RAG aux compagnies d'assurance et aux banques, il y a aussi des défis à relever. La qualité des données introduites dans les systèmes RAG est essentielle pour garantir des informations précises et fiables. En outre, les entreprises doivent s'assurer qu'elles respectent toutes les exigences réglementaires en matière de protection des données, notamment en ce qui concerne les données financières et de santé sensibles. Cependant, l'utilisation responsable de la RAG peut non seulement améliorer l'efficacité, mais aussi favoriser la transparence et la confiance des clients dans les institutions concernées.
Automatisation des services à la clientèle
RAG a le potentiel d'améliorer considérablement l'automatisation des services à la clientèle. Grâce à l'accès à de vastes bases de données et à des informations actualisées, les systèmes RAG peuvent fournir des réponses rapides et précises aux demandes des clients, ce qui améliore l'efficacité du service.
De nos jours, les clients attendent des réponses rapides et précises. Avec RAG, les entreprises peuvent développer des chatbots intelligents et des assistants virtuels capables de traiter efficacement des demandes complexes et de garantir un haut niveau de satisfaction des clients. Cet impact va changer durablement la manière dont les interactions avec les clients sont gérées.
L'utilisation des technologies RAG peut considérablement améliorer l'efficacité du service à la clientèle.
Potentiel de RAG pour lutter contre la désinformation
À une époque où la désinformation est très répandue, RAG offre la possibilité de fournir des informations fiables. En donnant accès à des données vérifiées et à des ressources actualisées, RAG peut contribuer à réduire la diffusion de fausses informations.
L'accès à des informations de qualité par RAG peut aider à réduire la diffusion de fausses nouvelles.
Cette capacité est particulièrement importante en temps de crise, où des informations précises sont cruciales. RAG pourrait être en mesure de soutenir une base d'informations de haute qualité qui aide les utilisateurs à prendre des décisions éclairées.
Impact de la technologie médicale basée sur l'IA sur les soins aux patients
Les technologies RAG ont le potentiel d'améliorer considérablement les soins aux patients grâce à l'accès aux données médicales actuelles et à leur analyse. La RAG peut aider les professionnels de la santé à poser des diagnostics plus précis et à élaborer des recommandations de traitement basées sur les connaissances les plus récentes.
L'utilisation du RAG dans la technologie médicale pourrait révolutionner les approches thérapeutiques.
L'intégration de données pertinentes et actuelles dans le processus décisionnel médical pourrait améliorer durablement la qualité des soins aux patients et favoriser la mise en œuvre de plans de traitement individuels. Au final, cela se traduit par de meilleurs résultats en matière de santé pour les patients.
Le défi de l'ambiguïté dans les requêtes des utilisateurs
L'ambiguïté dans les requêtes des utilisateurs est l'un des plus grands défis auxquels sont confrontés les systèmes RAG. Les utilisateurs posent souvent des questions en des termes peu clairs ou non spécifiques, ce qui rend difficile pour le RAG d'interpréter correctement l'intention et de fournir des réponses appropriées.
Pour relever ce défi, il faut développer des techniques avancées de traitement du langage naturel, capables de réagir au contexte des requêtes et de minimiser les malentendus.
L'ambiguïté des requêtes constitue l'un des principaux défis des systèmes RAG.
Utilisation de RAG dans la recherche sociale
L'utilisation de RAG dans la recherche sociale offre la possibilité d'obtenir des analyses et des aperçus complets. L'accès à d'énormes quantités de données et leur traitement permettent de mieux aborder les questions de sciences sociales.
Les systèmes RAG pourraient aider à identifier les tendances et les modèles dans les évolutions de la société et contribuer ainsi à l'améliorer.
Intégration de textes juridiques dans les systèmes RAG
L'intégration d'informations juridiques dans les systèmes RAG pourrait considérablement améliorer l'efficacité des conseils juridiques. En ayant accès aux textes juridiques et aux jugements actuellement disponibles, les juristes pourraient prendre des décisions mieux informées, basées sur une analyse complète.
L'intégration de textes juridiques dans les systèmes RAG peut faciliter considérablement les conseils juridiques.
RAG pourrait ainsi être un outil décisif dans la pratique juridique, susceptible d'améliorer la prise de décision et les stratégies juridiques.
Potentiel de RAG en matière d'analyse politique et de communication
RAG peut également jouer un rôle important dans le domaine de l'analyse et de la communication politiques. L'accès à des données et à des analyses d'opinion actualisées peut aider les décideurs politiques à prendre des décisions plus éclairées et à optimiser leurs stratégies de communication.
La capacité d'analyser et de traiter rapidement des informations pertinentes pourrait avoir un impact important sur la politique et le marketing.
L'utilisation de la RAG dans la politique pourrait changer la prise de décision et la communication publique.
Comment RAG pourrait changer la pratique du journalisme
RAG a le potentiel de modifier considérablement la pratique journalistique en permettant l'accès à des informations actualisées et à des analyses de données complètes. Les journalistes pourraient accéder plus efficacement à des informations pertinentes et fournir des reportages plus précis.
Ces changements pourraient non seulement améliorer la qualité des reportages, mais aussi renforcer la confiance du public dans les contenus journalistiques.
RAG a le potentiel de changer considérablement la pratique du journalisme en améliorant l'accès à l'information.
"How to" pour la mise en place d'un pipeline RAG
La mise en œuvre de la génération augmentée d'extraction (RAG) est une étape cruciale pour maximiser l'efficacité et la précision des systèmes d'information. La RAG combine les points forts de la récupération de données et des modèles génératifs pour fournir des réponses précises à des requêtes complexes. Cet article aborde les étapes essentielles de la mise en place d'un pipeline RAG, la structuration des messages-guides pour les Large Language Models (LLM) et un exemple de création d'application.
Identification de la source des données
Choisissez des sources de données appropriées, telles que des documents, des bases de données ou des API, qui sont pertinentes pour votre application RAG. Prenez en compte les formats tels que les PDF, les fichiers texte ou les enregistrements structurés.
Extraction et indexation de données
Extraire le contenu des sources de données sélectionnées et le préparer. Utilisez des techniques d'extraction de texte pour vous assurer que les informations sont disponibles dans un format permettant les recherches.
Mise en place d'un système de classement des documents
Enregistrez les données indexées dans un Base de données de vecteursLa base de données est un outil qui permet un accès rapide et une récupération efficace des informations pertinentes. Une base de données bien conçue est essentielle pour la performance du pipeline RAG.
Intégration d'un modèle de recherche
Choisissez un modèle d'extraction approprié, adapté à vos besoins spécifiques. Qu'il s'agisse d'une recherche traditionnelle par mots-clés ou d'algorithmes de recherche modernes basés sur des vecteurs, le modèle doit être en mesure d'identifier précisément les documents pertinents.
Connexion du LLM
Intégrer un Large Language Model qualifié qui prend en charge les aspects génératifs du pipeline RAG. Le LLM doit être capable de générer des réponses contextuelles basées sur les informations récupérées.
Tester et optimiser
Effectuez des tests approfondis du pipeline afin de vérifier son efficacité et sa fiabilité. Utilisez le feedback pour optimiser en permanence les processus de recherche et de génération afin d'améliorer l'expérience utilisateur.
Prompts structurés pour les LLM
Des formulations claires
Veillez à ce que vos invites soient claires et précises. Des instructions concrètes permettent au modèle de fournir plus facilement les bonnes informations.
Contextualisation
Ajoutez suffisamment de contexte pour permettre au LLM de comprendre et de traiter efficacement les informations pertinentes. Cela peut aider à améliorer la précision des réponses générées.
Utilisation de caractères génériques
Utilisez des caractères génériques pour faire varier les informations. Par exemple : "Donnez un résumé sur [sujet] basé sur les données récupérées".
Préférences de format
Indiquez le format de la réponse que vous souhaitez obtenir, qu'il s'agisse d'une énumération, d'un bref résumé ou d'une explication détaillée. Cela aidera le modèle à fournir des réponses structurées et attrayantes.
Amélioration itérative
Testez différentes variantes d'invites afin d'obtenir les meilleurs résultats. Utilisez le feed-back pour adapter et optimiser continuellement les formulations.
Exemples d'application
Pour illustrer la praticabilité de RAG, nous considérons le développement d'un Système de questions-réponses dans le domaine des informations médicales :
Sélectionner la source de données
Sélectionnez les articles médicaux et les études qui sont pertinents pour des demandes spécifiques des utilisateurs.
Indexation du contenu
Extraire les informations des articles sélectionnés et les enregistrer dans une base de données vectorielles afin de permettre une recherche rapide et précise.
Mise en œuvre du modèle d'extraction
Développer un modèle d'extraction qui récupère des informations pertinentes basées sur les questions de l'utilisateur, comme par exemple "Quels sont les symptômes typiques du diabète" ?
Concevoir un prompt pour le LLM
Créez une invite claire : "Veuillez expliquer les symptômes du diabète sur la base des informations récupérées".
Génération de la réponse
Le LLM traite les données récupérées et produit une réponse concise et compréhensible qui fournit des informations précieuses à l'utilisateur.
La mise en œuvre de ces étapes permet de développer un pipeline RAG performant qui fournit des réponses ciblées, de qualité et adaptées au contexte. En adoptant la bonne approche pour mettre en œuvre et optimiser les technologies RAG, les entreprises et les organisations peuvent améliorer considérablement l'efficacité de leurs systèmes d'information et offrir une réelle valeur ajoutée à leurs utilisateurs.
RAG avec Konfuzio
Le processus de Retrieval Augmented Generation (RAG) se compose des 3 étapes suivantes :
- Création d'une base de données vectorielles à partir de données spécifiques à un domaine :
La première étape de la mise en œuvre de RAG consiste à créer une Base de données de vecteurs à partir de vos données propriétaires spécifiques au domaine. Cette base de données sert de source de connaissances dans laquelle RAG puise pour fournir des réponses contextuelles pertinentes. Pour créer cette base de données vectorielle, suivez les étapes suivantes : - Conversion en vecteurs (encastrements) :
Pour rendre vos données spécifiques à un domaine utilisables par RAG, vous devez les convertir en vecteurs mathématiques. Ce processus de conversion est réalisé en faisant passer vos données par un modèle d'intégration, qui est un type particulier de modèle de langage large (LLM). Ces modèles d'intégration sont capables de convertir différents types de données, y compris du texte, des images, de la vidéo ou de l'audio, en tableaux ou en groupes de valeurs numériques. L'important est que ces valeurs numériques reflètent la signification du texte d'entrée, de la même manière qu'une autre personne comprend l'essence du texte lorsqu'elle le prononce à haute voix. - Création de bases de données vectorielles :
Une fois que vous avez obtenu les vecteurs qui représentent vos données spécifiques à un domaine, vous créez une base de données de vecteurs. Cette base de données sert de référentiel pour les informations sémantiquement riches, encodées sous forme de vecteurs. Dans cette base de données, RAG recherche des éléments sémantiquement similaires sur la base des représentations numériques des données stockées.
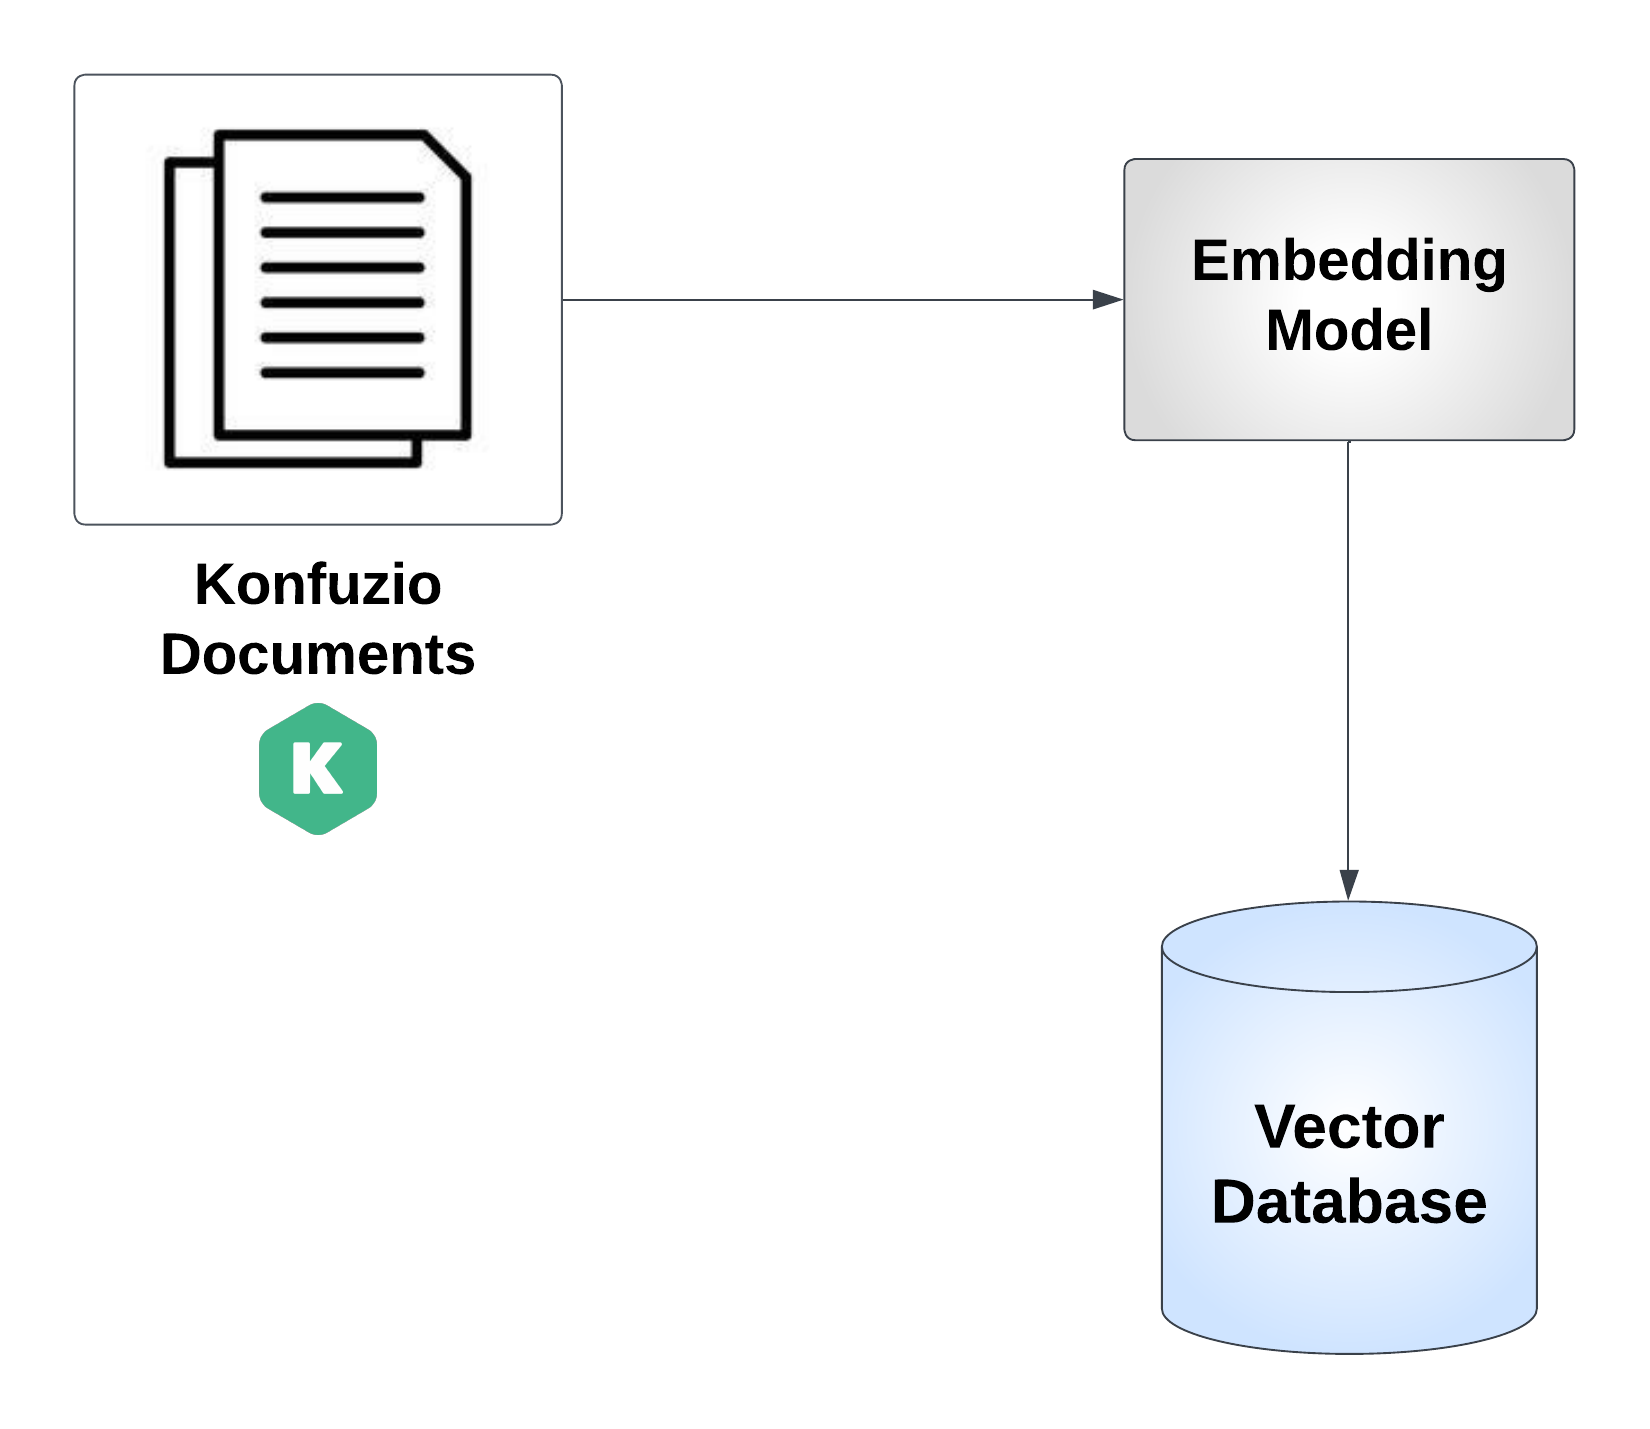
Le diagramme suivant illustre comment créer une base de données vectorielle à partir de vos données propriétaires spécifiques à un domaine. Pour créer votre base de données vectorielles, vous convertissez vos données en vecteurs en les faisant passer par un modèle d'intégration. Dans l'exemple suivant, nous convertissons des documents Konfuzio (Konfuzio Documents) qui contiennent les dernières informations sur Konfuzio. Les données peuvent être du texte, des images, des vidéos ou de l'audio :
Intégrer les connaissances spécialisées avec Konfuzio
Maintenant que vous avez construit une base de données vectorielles avec des connaissances spécifiques au domaine, l'étape suivante consiste à intégrer ces connaissances dans les LLM. Cette intégration se fait par le biais de ce que l'on appelle une "fenêtre contextuelle".
Imaginez la fenêtre contextuelle comme le champ de vision du LLM à un moment donné :
RAG élargit un LLM grâce à des connaissances spécifiques au domaine, issues de bases de données et des dernières informations disponibles sur Internet.
Cette fenêtre contextuelle permet au LLM d'accéder aux données importantes et de les intégrer. Cela permet de s'assurer que ses réponses sont non seulement cohérentes, mais également correctes d'un point de vue contextuel.
En intégrant des connaissances spécifiques au domaine dans la fenêtre contextuelle du LLM, RAG améliore la qualité des réponses générées. RAG permet au LLM d'accéder aux nombreuses données stockées dans la base de données vectorielles. Ses réponses sont ainsi mieux informées et plus pertinentes par rapport aux demandes de l'utilisateur.
Dans le diagramme ci-dessous, nous représentons le fonctionnement de RAG à l'exemple de "Konfuzio Documents" :
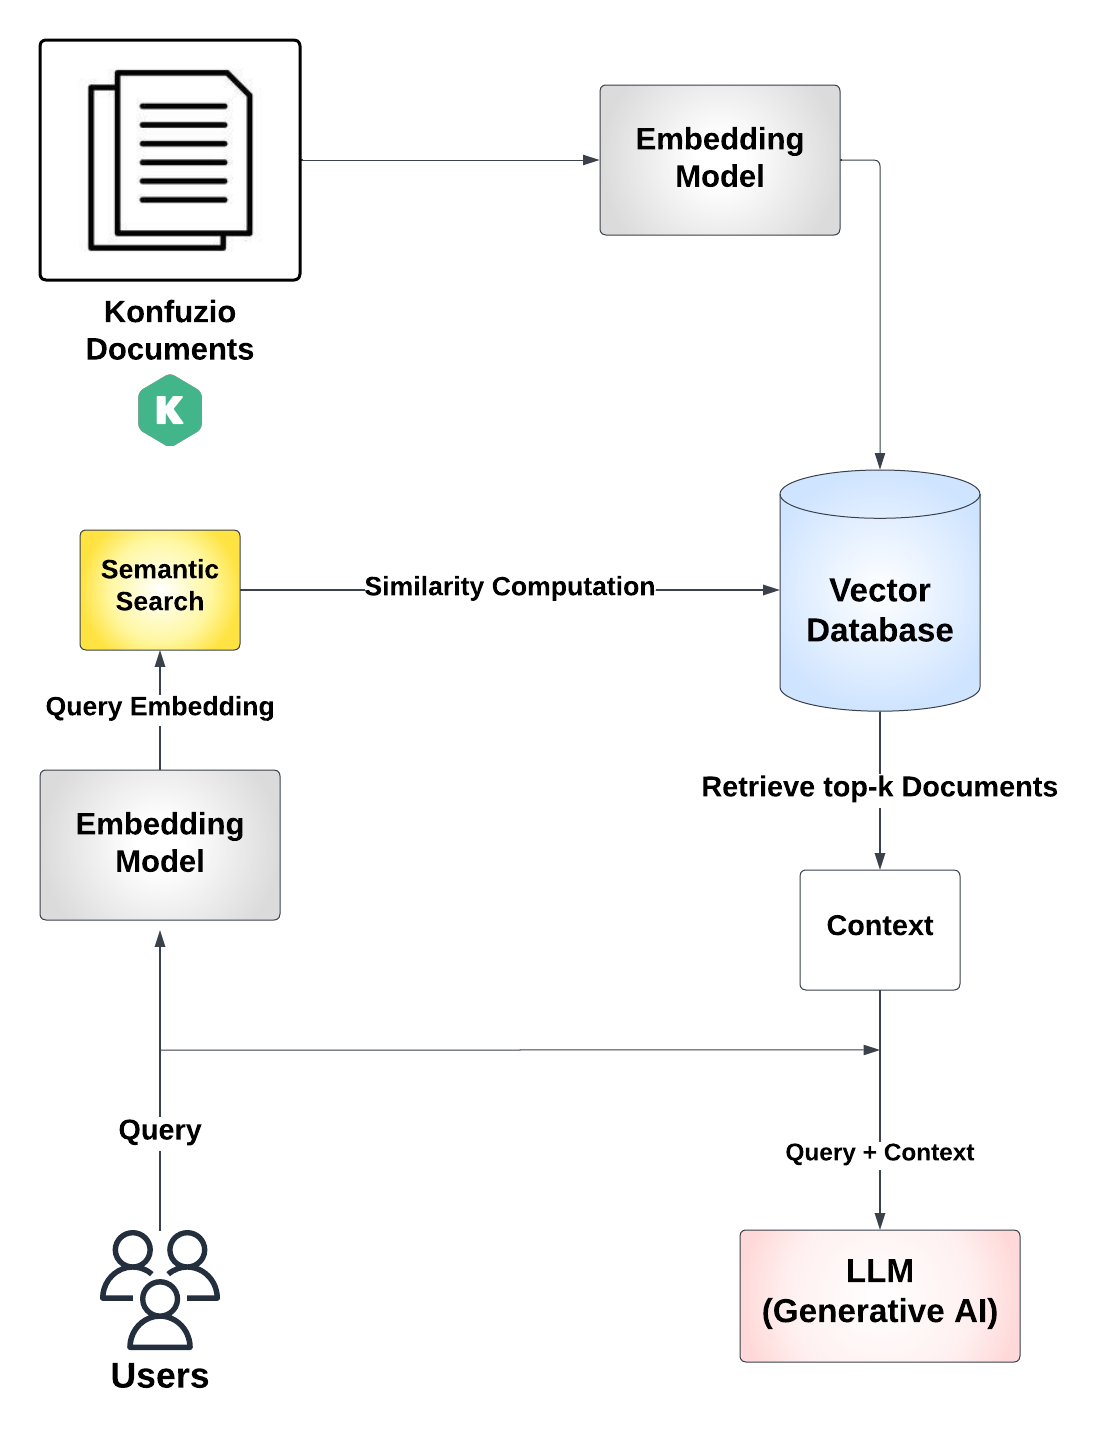
Grâce à notre flux de travail RAG, nous pouvons faire en sorte que notre Large Language Model (générateur) s'en tienne au contenu fiable et déjà vérifié de vos référentiels de connaissances. Ainsi, les demandes des utilisateurs reçoivent des informations pertinentes provenant de sources valides.
Et voilà, le résultat : Génération augmentée de la recherche
Mise à jour RAG
En plus de l'OCR habituelle, la structure des documents peut être Markdown ne sont pas représentés. Ainsi, même ceux qui ne sont pas LLMs multimodauxLes utilisateurs qui travaillent exclusivement sur du texte comprennent encore mieux les contenus présentés sous forme de titres, de listes, de tableaux et de textes courants. Cela signifie que Konfuzio vous permet d'utiliser Markdown pour présenter vos documents de manière plus compréhensible pour le LLM.
Markdown peut améliorer la précision et la performance de votre pipeline RAG !
La raison en est que cette représentation Markdown fournit plus d'informations et de contexte sur les documents qu'auparavant - sous forme de tableaux, d'illustrations, de cases à cocher, etc.
Retrieval Augmented Generation Challenges
La génération augmentée de recherche (RAG) a le potentiel de transformer considérablement la manière dont les systèmes traitent et fournissent les informations. Néanmoins, les développeurs et les entreprises sont confrontés à plusieurs défis qui peuvent nuire à l'efficacité de cette technologie. Les paragraphes suivants présentent les principaux défis liés à la RAG, suivis d'une comparaison avec d'autres approches, des développements futurs et des meilleures pratiques pour la mise en œuvre.
Quelle dimension de l'information les LLM peuvent-ils comprendre et traiter, et laquelle ne le peut pas ?
Dans ce blog post, nous allons examiner de plus près à partir de quel point les LLM échouent à répondre aux questions. Nous vous montrerons également comment des informations en temps réel peuvent être ajoutées aux Large Language Models.
Vous cherchez des informations supplémentaires sur l'utilisation des LLM pour le développement de DocumentGPT de Konfuzio ? Lisez le blog post informatif DocumentGPT - Libérez le pouvoir des LLM pour en savoir plus.
Limites des LLM
Les modèles linguistiques offrent des gains de productivité et nous aident dans diverses tâches. Mais comme nous l'avons déjà mentionné, il faut savoir que même les LLM basés sur l'IA ont leurs limites. Celles-ci sont particulièrement évidentes lorsque
- des informations en temps réel ou actualisées,
- Informations en temps réel,
- informations privées,
- des connaissances spécifiques au domaine,
- des connaissances sous-représentées dans le corpus de formation,
- les aspects juridiques et
- aspects linguistiques
peuvent être demandés. Demandez par exemple à ChatGPT quel est le taux d'inflation actuel en Allemagne. Vous obtiendrez - comme dans le test ci-dessus - une réponse comme celle-ci :
"Je m'excuse pour la confusion, mais en tant que modèle linguistique d'IA, je ne dispose pas de données en temps réel ni de fonctions de navigation. Mes réponses sont basées sur des informations disponibles jusqu'en septembre 2021. Je ne peux donc pas vous donner le taux d'inflation actuel en Allemagne".
Cette limitation constitue un problème majeur. ChatGPT, comme beaucoup d'autres LLM, n'est pas en mesure de fournir des informations opportunes et contextuelles qui pourraient être essentielles pour prendre des décisions éclairées.
Cause derrière LLM Limits
La raison pour laquelle les LLM sont "coincés" dans le temps et incapables de suivre le rythme du monde qui évolue rapidement est la suivante
Les données de formation et d'information de ChatGPT ont ce que l'on appelle un "point de coupure". Ainsi, si vous interrogez ChatGPT sur des événements ou des développements qui se sont produits après cette date, vous obtiendrez soit
- des informations qui semblent convaincantes mais qui sont complètement fausses, ce qui est connu sous le nom d'"hallucination", ou
- des réponses non objectives avec des recommandations implicites, comme par exemple
"Mes données ne vont que jusqu'à XXXX et je n'ai pas accès aux informations sur les événements qui ont eu lieu après cette date. Si vous avez besoin d'informations sur des événements survenus après septembre 2021, je vous recommande d'accéder à des sources d'information récentes ou à des moteurs de recherche pour suivre les derniers développements".
Retrieval Augmented Generation pour les données d'entreprise
C'est précisément là qu'intervient la Retrieval Augmented Generation (RAG). Cette approche comble le manque de connaissances des LLM et leur permet de fournir des informations contextuelles et actuelles grâce à l'intégration de mécanismes d'extraction externes. Dans les sections suivantes, nous expliquons plus en détail le concept de RAG et examinons comment RAG repousse les limites des LLM.
La principale différence entre RAG et Finetuning réside dans leur fonctionnement et leur objectif. La RAG se concentre sur l'amélioration du traitement du langage naturel par l'intégration d'informations externes, ce qui permet au modèle de mieux comprendre le contexte des requêtes et de générer des réponses plus précises. Le finetuning, quant à lui, vise à adapter spécifiquement un modèle de base pré-entraîné à une tâche ou un domaine particulier, en s'appuyant sur un ensemble limité de données d'entraînement.
Les deux méthodes sont utiles, mais elles ont des domaines d'application et des objectifs différents. RAG étend les capacités des LLM en intégrant des informations externes, tandis que le réglage fin vise à les adapter à des tâches ou des domaines spécifiques.
Qualité et pertinence des données
L'un des plus grands défis de la mise en œuvre de RAG est la Qualité et pertinence des données . Pour qu'un système RAG puisse fournir des réponses efficaces et précises, il est essentiel que les données sous-jacentes soient exactes, actuelles et pertinentes.
Sources de données
Il est essentiel de choisir les bonnes sources de données. Les informations provenant de sources obsolètes, imprécises ou non pertinentes peuvent donner lieu à des réponses erronées ou confuses.
Prétraitement
Un autre aspect de la qualité des données est le prétraitement des données. Des informations non structurées ou mal formatées peuvent nuire à l'efficacité du processus de récupération et de génération.
La qualité des données équivaut à la qualité des réponses qu'un système RAG peut fournir.
Problèmes de latence et indicateurs de performance
Problèmes de latence constituent un autre obstacle à l'utilisation efficace des RAG. Le temps nécessaire à la récupération et au traitement des informations pertinentes peut nuire à l'expérience utilisateur.
Réactivité
Les utilisateurs attendent généralement des réponses immédiates. Si la latence est élevée, le système peut être perçu comme peu fiable ou inefficace.
Indicateurs de performance
Il est essentiel de définir des métriques appropriées pour évaluer la performance d'un système RAG. Ces métriques doivent tenir compte non seulement de la précision des réponses, mais aussi des temps de latence et de l'efficacité de la récupération.
Une latence élevée peut avoir un impact considérable sur la satisfaction de l'utilisateur et réduire l'acceptation du système.
Ambiguïté dans les demandes
Un autre problème significatif rencontré dans les systèmes RAG est la Ambiguïté dans les demandes . Les utilisateurs posent souvent leurs questions en des termes peu clairs ou ambigus, ce qui fait que le système a du mal à comprendre leur intention.
Dépendance au contexte
La capacité à interpréter correctement les contextes est déterminante pour la pertinence des réponses récupérées.
Traitement du langage naturel
Les progrès réalisés dans le traitement du langage naturel peuvent aider à minimiser ces ambiguïtés, mais ils ne sont pas toujours exempts d'erreurs.
"L'ambiguïté dans les requêtes constitue un défi particulier pour les systèmes RAG, car elle peut nuire à la précision et à la pertinence des réponses".
Approches comparatives
Dans le monde de l'intelligence artificielle, il existe différentes approches pour répondre aux requêtes et traiter les informations. Deux méthodes proéminentes sont la génération augmentée par récupération (RAG) et le réglage fin classique des modèles.
RAG versus méthodes de réglage fin
La comparaison entre les méthodes RAG et Fine Tuning met en lumière les différences de stratégie et de résultats entre les deux approches.
RAG permet aux modèles d'extraire des informations de sources externes afin de mieux comprendre le contexte des demandes des utilisateurs et de générer des réponses plus précises. Il étend les capacités des LLM en les connectant à des bases de connaissances ou à d'autres sources d'information.
Le RAG offre une approche plus dynamique et plus flexible que le fine tuning, car il s'appuie sur la récupération permanente d'informations actualisées.
Mise au point est un processus par lequel un modèle de base pré-entraîné, tel qu'un Large Language Model, est adapté à des tâches ou des domaines spécifiques. Cela se fait en entraînant le modèle sur une quantité limitée de données d'entraînement spécifiques à la tâche. Au cours du processus de réglage fin, le modèle apprend comment se concentrer au mieux sur une tâche ou un domaine particulier et optimise ses capacités pour cette application spécifique.
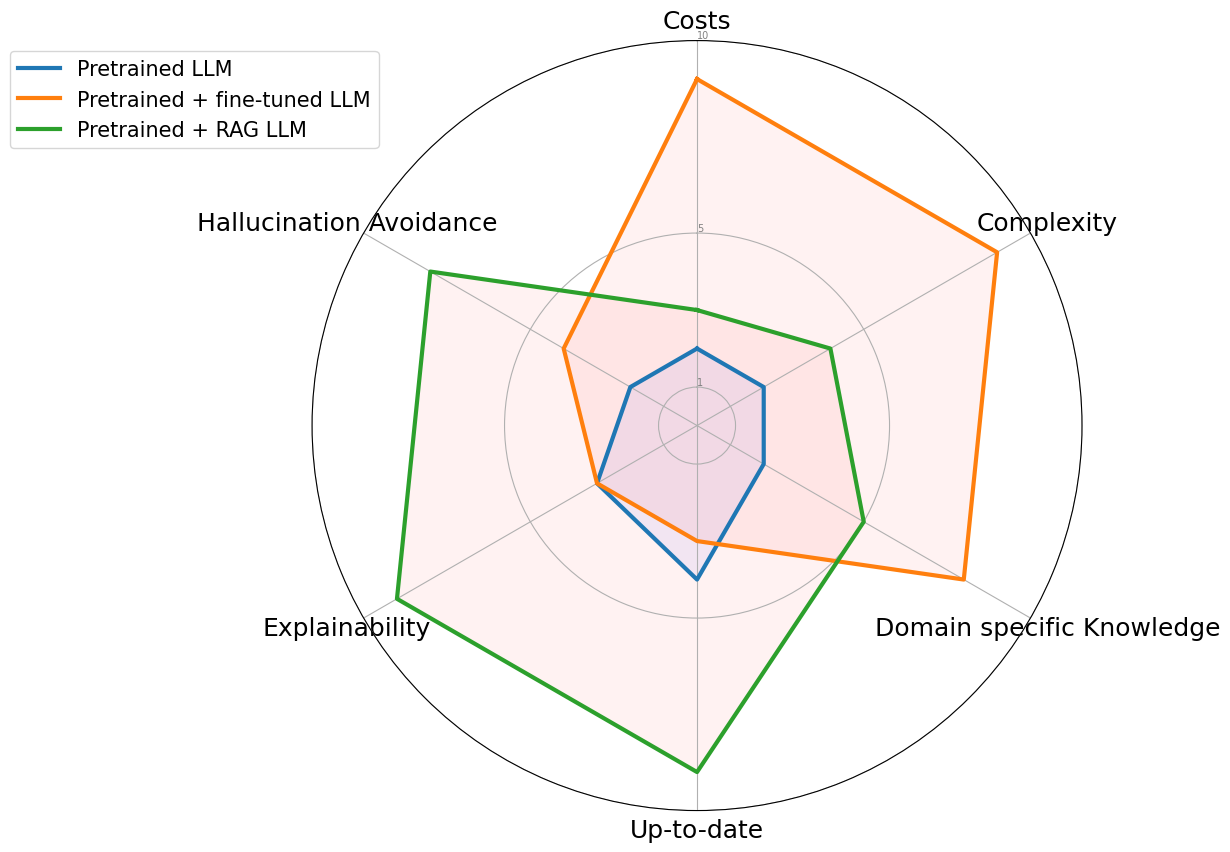
RAG permet essentiellement aux grands modèles de langage d'accéder directement à des données spécifiques lorsqu'ils répondent à certaines requêtes. Pour illustrer les différences entre RAG et les alternatives, considérez l'illustration suivante.
Le diagramme radar compare concrètement trois méthodes différentes :
- Pretrained LLM,
- Pretrained + finetuned LLM et
- Prétraité + RAG LLM.
Ce diagramme radar est une représentation graphique de données multidimensionnelles dans laquelle chaque méthode est évaluée en fonction de plusieurs critères, représentés sous forme d'axes dans le diagramme. Les critères comprennent
- Coûts,
- Complexité,
- Connaissances spécifiques au domaine,
- Actualité,
- Explicabilité et
- Éviter les hallucinations.
Chaque méthode est représentée sous forme de polygone dans le diagramme, les sommets du polygone correspondant aux valeurs de ces critères pour la méthode en question.
Par exemple
La méthode "Pretrained LLM" a des valeurs relativement faibles pour le "coût", la "complexité", les "connaissances spécifiques au domaine" et la "prévention des hallucinations", mais une valeur plus élevée pour l'"actualité" et l'"explicabilité".
En revanche, la méthode "Pretrained + finetuned LLM" présente des valeurs plus élevées pour "Cost", "Complexity", "Domain Specific Knowledge" et "Hallucination Avoidance", mais des valeurs plus faibles pour "Actuality" et "Explicability". Enfin, la méthode "Pretrained + RAG LLM" a un modèle unique avec des valeurs élevées pour "Up-to-date", "Explainability" et "Domain specific knowledge".
La méthode "Pretrained + RAG LLM" se caractérise par des connaissances spécifiques au domaine, des informations actualisées, une explicabilité et la prévention des hallucinations. Cela est probablement dû au fait que l'approche RAG permet au modèle d'expliquer les informations à l'aide de structures de graphes, ce qui peut améliorer sa compréhension, éviter les hallucinations et fournir des réponses plus transparentes et plus précises dans certains domaines.
Évaluation des performances par rapport aux modèles traditionnels
Lors de l'évaluation des performances des systèmes RAG par rapport aux modèles traditionnels, il est important de prendre en compte plusieurs facteurs.
Précision
RAG peut souvent fournir des réponses plus précises et plus pertinentes, car il puise dans une base d'informations plus large.
Données en temps réel
Les modèles RAG peuvent accéder à de nouvelles données en temps réel, ce qui leur donne un avantage certain sur les modèles statiques.
La capacité de RAG à accéder en temps réel aux données pertinentes est un avantage significatif par rapport aux modèles traditionnels.
Développements futurs
L'avenir de RAG s'annonce prometteur, notamment en termes d'avancées technologiques et d'intégration avec d'autres systèmes d'IA.
Progrès technologiques
Les développements technologiques continueront à améliorer les systèmes RAG et à élargir leurs possibilités d'utilisation.
Nouveautés dans l'IA
Les progrès réalisés dans le traitement du langage naturel et l'apprentissage automatique permettront d'améliorer l'efficacité et la précision des modèles RAG.
Optimisation des algorithmes
Des algorithmes innovants de récupération et de traitement des données peuvent améliorer les performances des systèmes RAG.
Conclusion
L'intégration croissante des Large Language Models (LLMs) dans notre quotidien a sans aucun doute apporté de nombreux avantages, mais elle se heurte également à des limites. Le défi réside dans le fait que les LLM, tels que GPT-3, GPT-4, Llama 2 et Mistral-7B, ont des difficultés à fournir des informations contextuelles en temps réel, ainsi que des connaissances spécifiques au domaine. Cela constitue un obstacle important, en particulier lorsque des réponses précises et pertinentes sont requises.
Retrieval Augmented Generation (RAG) s'avère être une solution prometteuse à cet égard. RAG permet d'intégrer des systèmes d'extraction externes dans les Large Language Models, ce qui permet à ces modèles d'accéder à de vastes bases de connaissances et à des informations actualisées. Ils peuvent ainsi mieux comprendre les requêtes définies par l'utilisateur et fournir des réponses plus précises et contextuelles.
Alors pourquoi utiliser RAG et ne pas miser sur des approches alternatives ?
- RAG permet de fournir des informations en temps réel et des connaissances actualisées, ce qui est particulièrement important dans les domaines qui évoluent rapidement et pour prendre des décisions éclairées.
- RAG permet d'intégrer des connaissances spécifiques au domaine dans la génération de réponses. Cela est essentiel lorsque des connaissances spécialisées sont requises.
- Contrairement à certaines approches alternatives, RAG offre une méthode plus transparente et compréhensible pour répondre aux questions, car elle se base sur des données et des faits existants.
- RAG minimise la probabilité d'informations fausses ou inventées en ayant recours à des sources externes fiables.
En résumé, Retrieval Augmented Generation comble les lacunes dans les capacités des LLM et permet d'obtenir des réponses fiables à des questions complexes. Cela en fait une méthode prometteuse pour l'avenir de la communication avec les intelligences artificielles et le soutien dans un large éventail d'applications.
Avez-vous des questions ou êtes-vous intéressé par une démonstration de la Konfuzio Infrastructure ?
N'hésitez pas à nous envoyer un message. Notre équipe d'experts se fera un plaisir de vous conseiller.

 FR
 DE
 EN
 ES